
Jeśli scraper oparty na Playwright lub Selenium zwalnia na VPS-ie lub przekracza termin, dodatkowa pamięć RAM może pomóc. Sam timeout nie wskazuje jednak, który zasób zwiększyć. Dobierz VPS do web scrapingu, mierząc całe zadanie: procesy przeglądarki, zapisywanie wyników i usługi na tym samym hoście. Potem dostosuj współbieżność i sprawdź, czy wymagane dane zostają zapisane na czas.
Przetestuj konfigurację VPS z własnym obciążeniem
Przy zadaniu przeglądarkowym z ograniczoną współbieżnością i niewielką liczbą usług towarzyszących zacząłbym od 4 GB RAM i 2 vCPU. Sprawdź 8 GB RAM i 4 vCPU, jeśli mniejsza konfiguracja nie pozwala ukończyć zadania w terminie lub zostawia zbyt mało zasobów innym usługom. To punkty wyjścia do prób, a nie oficjalne minima Playwright czy Selenium ani gwarancja określonej liczby przeglądarek.
| Punkt wyjścia | Kiedy testować |
|---|---|
| 4 GB RAM / 2 vCPU | Zadanie przeglądarkowe z ograniczoną współbieżnością i niewielką liczbą usług towarzyszących |
| 8 GB RAM / 4 vCPU | Pomiary pokazują, że mniejsza konfiguracja nie wystarcza do zadania lub usług towarzyszących |
| Inny stosunek RAM do CPU | Pomiary ujawniają potrzebę, której nie zaspokajają dwie pierwsze konfiguracje |
| Mniejsza współbieżność lub mniej pracy w przeglądarce | Dodatkowa praca równoległa pogarsza wyniki albo dane są dostępne bez renderowania |
Zachowaj obecny host jako jedną z opcji. Jeśli już wykonuje wymaganą ekstrakcję w potrzebnych warunkach, wyniki mogą uzasadnić pozostanie przy nim. Jeśli testujesz nowy host, sprawdź nasze plany VPS z systemem Linux i wybierz RAM oraz vCPU odpowiednie dla obciążenia. Zapewniamy dostęp root, aby można było zainstalować Playwright lub Selenium i skonfigurować testowane środowisko przeglądarki oraz limity zasobów.
Sprawdź też, czy uzyskanie danych wymaga wyrenderowanej strony. Jeśli autoryzowana ścieżka HTTP lub API zwraca wymagane dane, oceń to obciążenie oddzielnie. Zachowaj te same wymagania dotyczące wyników. Zwrócenie mniejszej liczby pól lub pominięcie trudnych stron zmienia zadanie. Porównanie zasobów potrzebnych do pełnej i niepełnej ekstrakcji nie daje użytecznych wyników.
Uwzględnij całe obciążenie przeglądarek
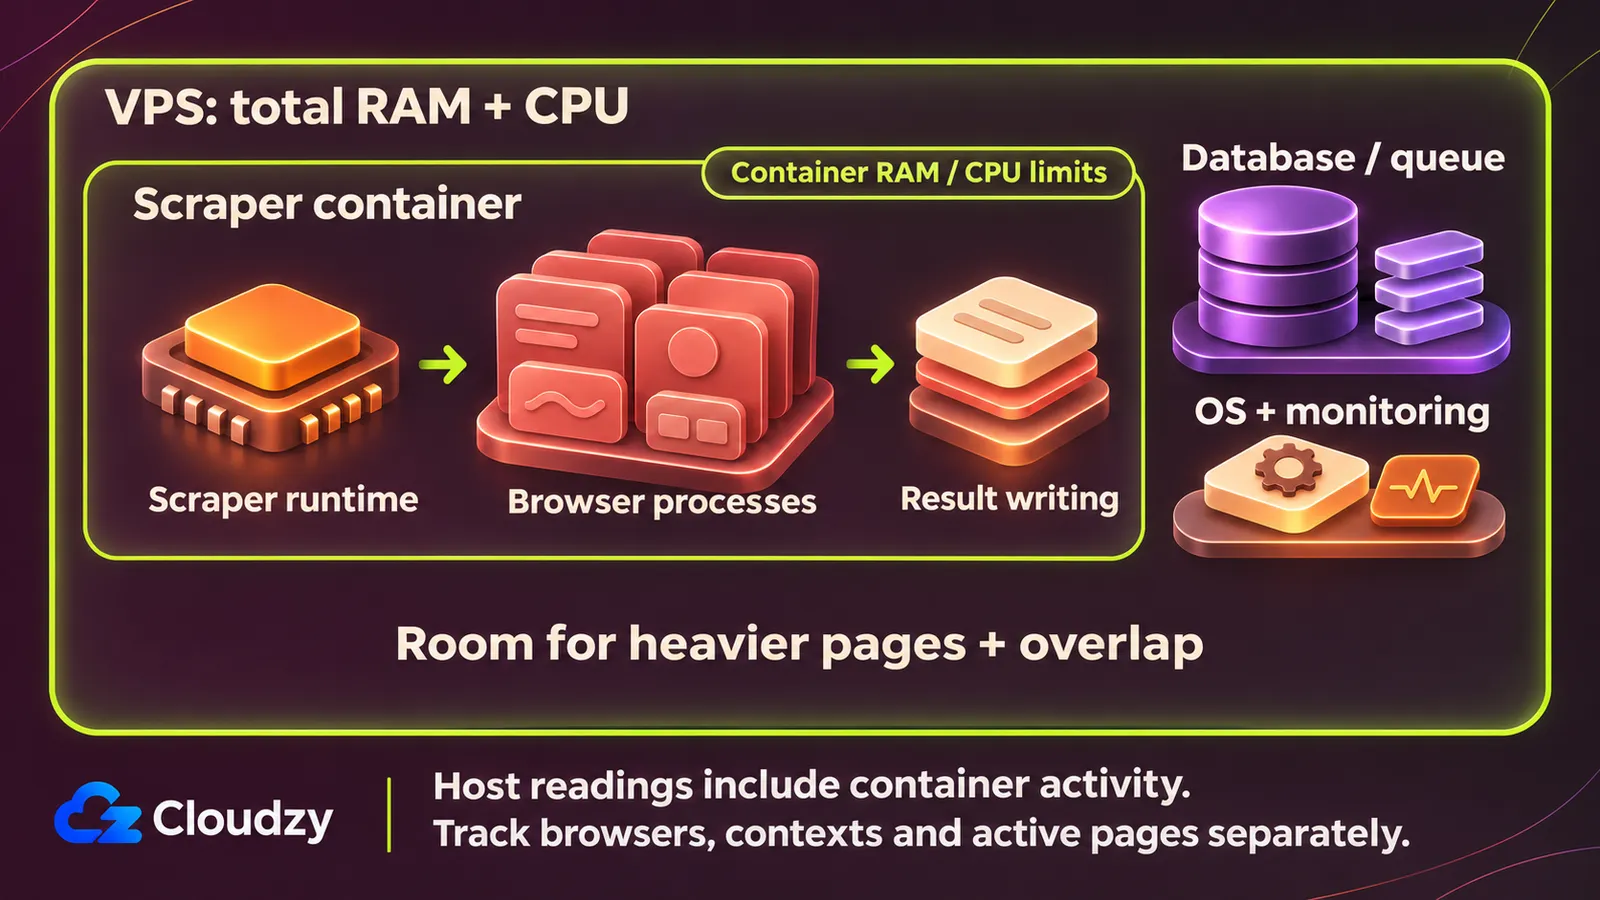
Przy scraperze działającym obok bazy danych w dostępnych zasobach muszą się zmieścić środowisko wykonawcze, procesy przeglądarki, aktywne strony i praca bazy. Architektura wieloprocesowa Chromium oddziela proces przeglądarki od procesów renderowania i innych typów procesów. Przy doborze zasobów zalecam uwzględnienie pełnego obciążenia przed interpretacją odczytów pojedynczego procesu.
Instancja przeglądarki to uruchomiona przeglądarka zarządzana przez kod automatyzacji. W Playwright kontekst izoluje stan przeglądarki, a strony należą do kontekstu. Dokumentacja kontekstów przeglądarki Playwright opisuje izolację podobną do trybu incognito i kilka kontekstów w jednej przeglądarce. Tworzenie kontekstów wymaga według niej niewielu zasobów, ale nie podaje konkretnej ilości RAM. Uwzględnij pracujące w nich strony.
Ta sama dokumentacja odróżnia konteksty tworzone ręcznie przy użyciu biblioteki od automatycznie tworzonych przez Playwright Test. Scraper korzystający z biblioteki potrzebuje własnego limitu współbieżności. Ustawienia procesów roboczych programu uruchamiającego testy nie wyznaczają tego limitu. Osobno zanotuj liczbę instancji przeglądarki, kontekstów i aktywnych stron. Nie zastępuj tych danych innymi ani nie zakładaj stałej zależności między kartami i procesami Chromium.
W Selenium zapisz sesje sterownika i powiązane procesy przeglądarki. Dokumentacja sesji sterownika rozróżnia wykonanie lokalne i zdalne oraz zaleca quit do kończenia sesji. Zamknięcie okna to inna operacja. W Playwright API zamykania kontekstu zamyka przypisane do niego strony. Stosuj ten sam sposób sprzątania po każdym uruchomieniu. Nie zaczynaj kolejnego testu z sesjami ukończonych zadań.
Przed pomiarami opisz konfigurację:
- System operacyjny, architektura oraz wersje środowiska wykonawczego, pakietu automatyzacji i przeglądarek.
- Uruchomienie natywne lub w kontenerach oraz miejsce działania środowiska wykonawczego, przeglądarki i usług obsługujących wyniki.
- Instancje przeglądarek, konteksty Playwright i aktywne strony albo sesje Selenium, a także limit współbieżności i sposób sprzątania po zadaniu.
- Zestaw celów i stron, operacje ekstrakcji, zapis wyników, pobieranie plików, logi i wymagania dotyczące miejsca na dane.
- Usługi towarzyszące na tym samym hoście, w tym bazy danych, kolejki i monitoring.
- Ustawienia pamięci, CPU i IPC kontenera, jeśli mają zastosowanie.
- Harmonogram, przewidywane nakładanie się uruchomień, typowy czas trwania i termin ukończenia.
Zapisz wszelkie zależności od środowiska graficznego. Praca bez nadzoru różni się od pracy bez interfejsu graficznego. Proces obsługujący interfejs pulpitu nadal wymaga sesji graficznej. Różnica między GUI a trybem headless ma znaczenie, gdy automatyzacja wykracza poza strony przeglądarki. Dopisz do konfiguracji tę dodatkową pracę, zamiast przypisywać jej zużycie zasobów Playwright lub Selenium.
Zmierz reprezentatywne uruchomienie przed zwiększeniem współbieżności
Zacznij od jednej aktywnej ekstrakcji. Zmierz liczbę pomyślnie zakończonych zadań i czas, a następnie stopniowo zwiększaj limit współbieżności przy stałym obciążeniu. Zalecam zapisywanie wyników obserwacji hosta, a w stosownych przypadkach także kontenera. Przed przyjęciem limitu do eksploatacji sprawdź go w normalnej pracy i podczas planowanego nakładania się zadań.
Użyj istniejącego, dozwolonego zadania ekstrakcji. Poniższe polecenia obserwują maszynę oraz kontener. Nie uruchamiają scrapera ani nie ustanawiają benchmarku. Potrzebujesz dostępu do powłoki hosta Linux. Do pomiarów Docker potrzebujesz również dostępu do demona i istniejącego kontenera. Zastąp scraper nazwą kontenera.
-
Zapisz konfigurację i stan początkowy. Uzupełnij opis konfiguracji i sprawdź pamięć oraz CPU hosta przed rozpoczęciem ekstrakcji. Pozostaw usługi towarzyszące w normalnym stanie. Przy uruchomieniu natywnym wykorzystaj obserwacje procesów, by objąć środowisko wykonawcze i całe drzewo procesów przeglądarki. Pomiń polecenia Docker i pola dotyczące kontenerów. W przypadku kontenerów ustal, które procesy działają w każdym z nich, a które poza nimi.
-
Obserwuj host i efektywne limity kontenerów. Polecenia dotyczące hosta uruchamiaj na hoście, a ciągłe pomiary wykonuj w osobnych terminalach w czasie pracy zadania:
free -h
vmstat -y 1
docker inspect --type=container scraper
docker stats scraper
free -h drukuje odczyt w czytelnych jednostkach. Podręcznik free z procps definiuje available jako ilość pamięci, jakiej nowe aplikacje mogą prawdopodobnie użyć bez swapu. Interpretuj szacunek w kontekście obciążenia. Kolumna free liczy nieużywaną pamięć, odpowiada więc na węższe pytanie. Powtarzaj odczyt podczas działania i zapisz najniższą zaobserwowaną wartość dostępnej pamięci.
vmstat -y 1 wyświetla pomiary co sekundę. Podręcznik vmstat z procps podaje, że -y pomija pierwszy raport, który w przeciwnym razie zawiera statystyki od startu. Pola si i so pokazują ilość pamięci odczytanej ze swapu i zapisanej do niego w ciągu sekundy. Pola CPU obejmują id dla bezczynności, wa dla oczekiwania na I/O i st dla czasu CPU odebranego maszynie wirtualnej. Zestawiaj odczyty z postępami i błędami. Same nie określają przyczyny.
Opis polecenia inspect w Docker dokumentuje konfigurację w formacie JSON oraz filtr typu kontenera. Zanotuj efektywną konfigurację pamięci, CPU i IPC. Przed udostępnieniem sprawdź, czy wynik nie zawiera poufnych zmiennych środowiskowych. Dokumentacja ograniczeń zasobów Docker odróżnia limit --memory od ograniczeń CPU, takich jak --cpus i kwota CPU. Kwota ogranicza czas wykonywania na CPU. Liczba vCPU hosta nie określa zasobów dostępnych kontenerowi. Zanotuj też nieustawione limity i sprawdź konfigurację swapu.
Opis polecenia stats w Docker wyjaśnia bieżące odczyty CPU, użycia i limitu pamięci, sieci i blokowego I/O. W systemie Linux CLI odejmuje pamięć podręczną od użycia pamięci, więc wynik może się różnić od danych innego źródła. PIDS obejmuje procesy i wątki jądra, a nie liczbę przeglądarek. Odczyty z hosta już obejmują aktywność kontenera. Nie sumuj obu odczytów jak niezależnych zasobów. Zachowaj pokazane jednostki, w tym GiB, MiB, GB i surowe bajty. Przerwij ciągły pomiar za pomocą Ctrl-C.
-
Uruchom jedną aktywną ekstrakcję na różnych typach stron. Uwzględnij reprezentatywne lekkie i ciężkie strony, uruchomienie, nawigację, ekstrakcję i zapis. Zapisz udane i nieudane ekstrakcje oraz całkowity czas. Za zakończoną uznaj ekstrakcję, której wymagane wyniki zostały zapisane. Pomyślną ponowną próbę policz raz jako zakończoną, pozostawiając próby nieudane w rejestrze błędów. To proponowana reguła liczenia, a nie wartość domyślna narzędzia.
-
Zwiększaj limit stopniowo. Zachowaj wersje, topologię, zestaw stron, wyniki i pozostałe ustawienia. Każdy limit zapisz oddzielnie. Przestań go zwiększać, gdy liczba użytecznych zakończeń nie rośnie, przybywa błędów, termin zostaje przekroczony lub zostaje zbyt mała rezerwa. To zalecane granice testu, nie uniwersalne progi obciążenia. Więcej pracy w toku samo w sobie nie jest poprawą.
-
Sprawdź długotrwałą pracę i nakładanie zadań. Działaj z wybranym limitem przez typowy czas zadania i podczas oczekiwanego nakładania się z usługami towarzyszącymi lub inną zaplanowaną ekstrakcją. Powtórz przed akceptacją konfiguracji. Przy porównaniu z innym hostem utrzymaj to samo zadanie i w miarę możliwości zmieniaj jeden zasób naraz. Jednoczesne zwiększenie RAM i vCPU nie pozwala oddzielić wpływu RAM ani wykazać proporcjonalnego przyspieszenia.
Dla każdej konfiguracji VPS i każdego limitu współbieżności zanotuj limity zasobów, odczyty pamięci i CPU, aktywność swapu, udane i nieudane ekstrakcje, czas oraz ostateczną decyzję.
Najwyższą wartość w próbkach nazywaj najwyższą wartością zaobserwowaną w próbkach. Próbkowanie może pominąć krótkie skoki. Opcja Docker --no-stream zwraca tylko pierwszy odczyt i nie ustala szczytu dla całego uruchomienia. Wartości niezaobserwowane pozostaw jako nieznane. Wypełnienie luki szacunkiem osłabi porównanie.
Rezerwa eksploatacyjna to zapas na cięższe strony, różnice między uruchomieniami i nakładające się zadania. Ustal ją na podstawie warunków sprawdzonych w testach zamiast stałej wartości procentowej. Jeśli zadanie ledwo mieści się w terminie lub nie zostawia zapasu na te warunki, ogranicz współbieżność lub przetestuj większą konfigurację.
Wybierz zmianę ustawień albo zwiększenie zasobów
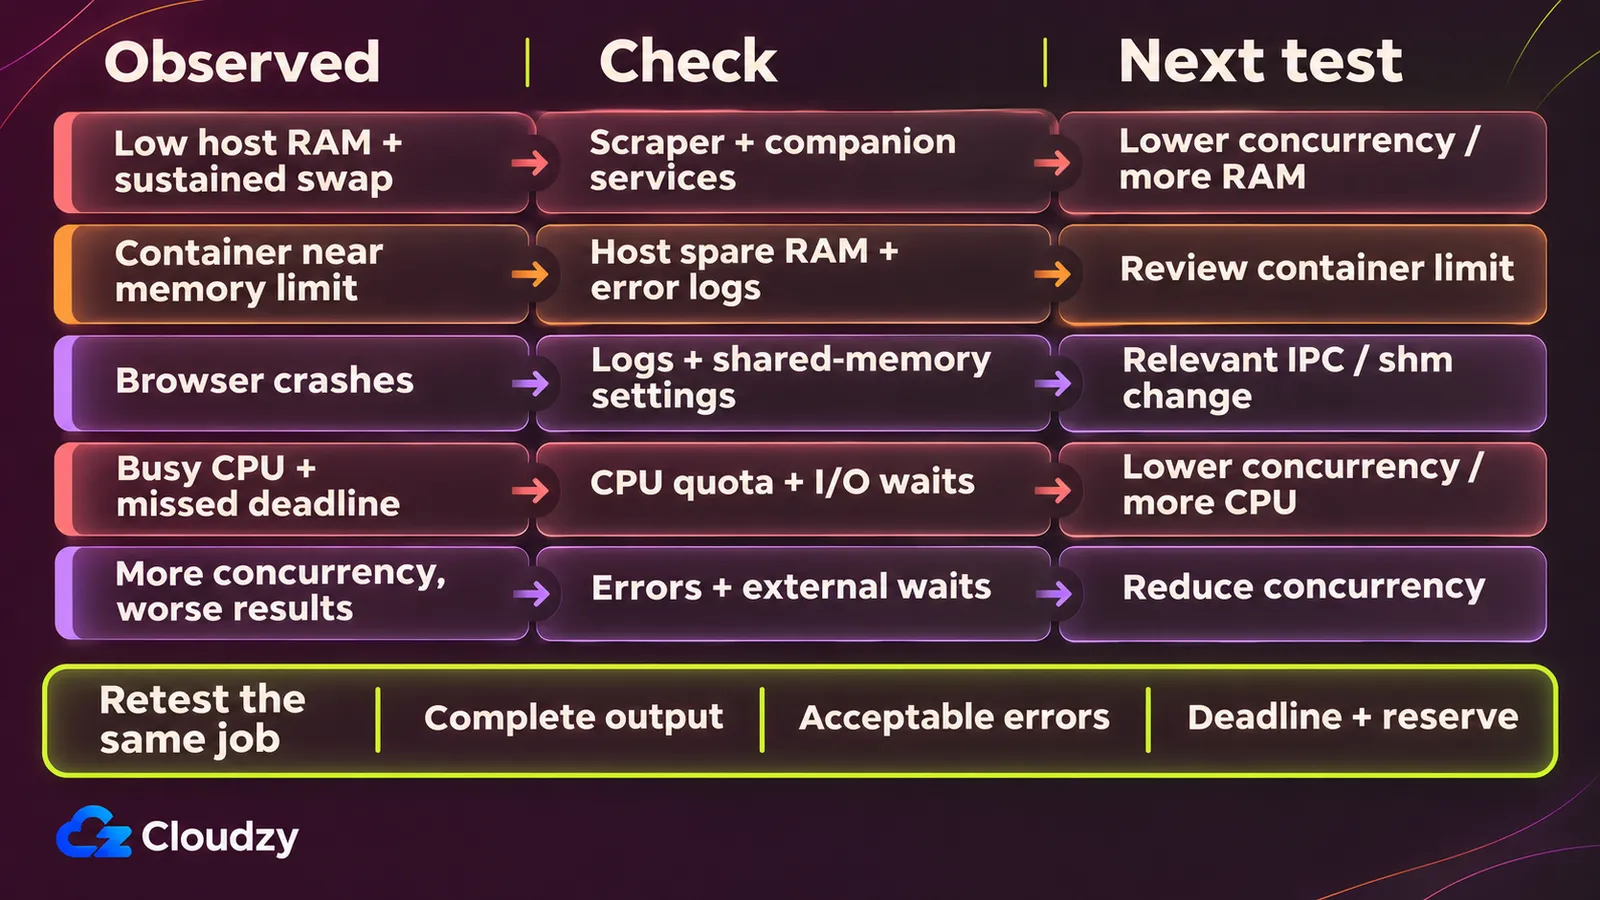
Jeśli kontener osiąga limit pamięci przy wolnej pamięci RAM na hoście, sprawdź limit przed rozbudową VPS-a. Jeśli problem dotyczy samego hosta, porównaj zmniejszenie współbieżności z większym przydziałem zasobów. Wybierz kolejną zmianę według tabeli, powtórz tę samą ekstrakcję i porównaj gotowe wyniki, błędy i czas.
| Zaobserwowane zjawisko | Następna kontrola lub działanie | Kryterium akceptacji po zmianie |
|---|---|---|
| Dostępna pamięć hosta spada, a długotrwałej aktywności swapu towarzyszą słabsze wyniki | Porównaj całe obciążenie i usługi towarzyszące. Oceń mniejszą współbieżność lub większą ilość RAM | Powtórzona ekstrakcja kończy się na czas z uzasadnioną rezerwą |
| Kontener zbliża się do ustawionego limitu pamięci, choć host ma zapas | Przed zmianą limitu sprawdź rzeczywistą wartość i poszukaj dowodów w błędach lub logach | Ponownie przetestuj obciążenie. Sama dodatkowa pamięć RAM hosta nie dowodzi, że problem ustąpił |
| Awarie przeglądarki uzasadniają sprawdzenie konfiguracji pamięci współdzielonej | Odróżniaj /dev/shm od całkowitej pamięci RAM i sprawdź zalecenia dotyczące Docker IPC dla Chromium |
Przetestuj tę konfigurację ponownie. Sam komunikat błędu nie pozwala stwierdzić wyczerpania pamięci |
| CPU pozostaje obciążony lub podejrzewasz limit CPU, a zadanie nie mieści się w terminie | Sprawdź kwotę, obciążenie oraz kontekst I/O i oczekiwania. Oceń limit współbieżności lub przydział CPU | Więcej pracy kończy się pomyślnie w terminie. Nie zakładaj przyspieszenia proporcjonalnego do zasobów |
| Większa współbieżność zwiększa liczbę błędów lub czas bez wzrostu liczby użytecznych wyników | Zmniejsz limit i przeanalizuj zachowanie obciążenia oraz oczekiwanie na operacje zewnętrzne | Wymagane dane zostają poprawnie wyodrębnione w wyznaczonym czasie |
Zastosowanie pamięci współdzielonej przez Chromium zależy od kompilacji i ustawień uruchamiania. W konfiguracjach z /dev/shm sprawdź system plików pamięci współdzielonej kontenera. Opis polecenia uruchamiania kontenerów Docker podaje, że --shm-size określa rozmiar /dev/shm, a wartość domyślna to 64m. Parametr określa rozmiar systemu plików, nie łączny przydział RAM kontenera. Zwiększenie limitu pamięci Docker dla Playwright i zmiana pamięci współdzielonej to różne działania.
Zalecenia konfiguracji Docker dla Playwright wskazują --ipc=host dla Chromium i --init do zarządzania procesami. Przy przeszukiwaniu niezaufanych witryn zalecany jest osobny użytkownik i profil seccomp. Uruchomienie przeglądarki jako root wyłącza piaskownicę Chromium. Zastosuj całą konfigurację odpowiednią dla przeszukiwania. Ustawienie IPC nie jest ogólnym zaleceniem bezpieczeństwa, a przykład testu end-to-end dla zaufanej witryny nie jest instrukcją przeszukiwania witryn niezaufanych.
Zachowaj zapis zaakceptowanego obciążenia wraz z konfiguracją zadania. Sprawdź ponownie, gdy zmienią się strony, wersje, efektywne limity lub terminy nakładających się zadań.
Jeśli pomiary uzasadniają wybór innego hosta Linux do kontenerów, oferujemy wdrożenie Docker jednym kliknięciem. Wybierz zasoby na podstawie zaakceptowanych pomiarów i zachowaj sprawdzone ustawienia kontenera w nowym wdrożeniu.
Najczęstsze pytania
Czy zdalna przeglądarka eliminuje zapotrzebowanie scrapera na lokalną pamięć RAM?
Przy zdalnej przeglądarce nadal trzeba przydzielić zasoby lokalnemu środowisku lub klientowi, logice ekstrakcji i obsłudze wyników w miejscach ich działania. Dokumentacja połączeń zdalnych Playwright opisuje serwer działający oddzielnie od kodu wywołującego. Zmierz klienta i usługę zdalną osobno. Sama architektura nie określa liczbowej oszczędności lokalnej pamięci.
Czy asynchroniczne wykonanie zmniejsza zużycie RAM przez Playwright?
Niekoniecznie. Porównaj implementację asynchroniczną z bieżącą przy tym samym limicie współbieżności, stronach i wymaganiach dotyczących wyników. Przed stwierdzeniem oszczędności zapisz zużycie RAM, zakończone ekstrakcje i czas. Zalecenia dotyczące limitów zasobów Docker wskazują na konieczność sprawdzenia zapotrzebowania aplikacji na pamięć przed wdrożeniem produkcyjnym.
Czy mogę dobrać VPS do scrapingu według orientacyjnego zapotrzebowania na RAM dla Selenium Grid?
Dokumentacja doboru zasobów Selenium Grid podaje około 1 CPU i 1 GB RAM na przeglądarkę jako punkt odniesienia i wyraźnie zaznacza, że może nie odpowiadać Twoim warunkom. Zaleca ciągłe pomiary wydajności. Stosuj wartość właściwą dla Grid z tym zastrzeżeniem. Nie stanowi wzoru na wydajność scrapera ani minimum dla lokalnego WebDriver.
Dyskusja
Komentarze
Zaloguj się, aby dołączyć do dyskusji.