
Dwie bazy mogą zajmować tyle samo dysku i potrzebować różnych VPS. Jedna stale odczytuje kilka wierszy; druga ciągle zapisuje, buduje duże indeksy albo musi szybko odtworzyć się po awarii. Wybór zaczyna się od tych różnic, przed porównaniem dostawców.
VPS bez administracji oznacza odpowiedzialność za działanie bazy. PostgreSQL, MySQL i MariaDB potrzebują różnych budżetów pamięci; odtwarzanie trzeba projektować wraz z serwerem głównym. Konfiguracja początkowa musi zostawiać zapas na kopie i konserwację oraz przejść reprezentatywny test.
Zmierz obciążenie bazy przed wyborem planu
Przed wyborem CPU, RAM i dysku zmierz aktywne dane i indeksy, zapytania równoległe w szczycie, wzrost i wymagania odtwarzania. Dodawaj zasoby według zmierzonego ograniczenia. Uwzględnij miejsce na konserwację i szczyt aplikacji przy wspólnym hoście; budżet musi pokrywać szczyt i zwykłą pracę.
Zbiór roboczy to często używane dane i indeksy korzystające z pozostawania w RAM. Rozmiar zapisany obejmuje też dane zimne. Otwarte połączenia nie są aktywnymi zapytaniami: bezczynni klienci i równoległe sortowania wymagają innych CPU i RAM. Zapisuj oba pomiary, charakter zapytań i proporcję odczytu/zapisu.
Ustal wymagania zakupowe na podstawie reprezentatywnego okresu dużej aktywności:
- Zmierz szczyt pamięci aplikacji, jeśli ma współdzielić VPS.
- Zapisz rozmiar danych i indeksów, szacowany zbiór roboczy, równoległe operacje i wzrost w planowanym horyzoncie.
- Zmierz produkcję logów i największą przewidywaną budowę indeksu, przepisanie tabeli lub konserwację.
- Ustal docelowe opóźnienie p95, dopuszczalną utratę danych i czas odtwarzania.
- Wybierz miejsce działania aplikacji i sprawdź trasę do bazy.
Dokumentacja monitorowania PostgreSQL zaleca łączenie statystyk bazy z narzędziami systemu. Mierz CPU, presję pamięci i dysk razem z czasami zapytań i commitów. Wzrost opóźnienia podczas kopii wymaga zbadania, nawet jeśli test bez obciążenia wygląda dobrze.
Dedykowane vCPU dają stały dostęp do przydzielonego CPU, ale nie cały fizyczny serwer ani gwarancję IOPS. Oceniaj CPU, RAM i zachowanie dysku oddzielnie. Jeśli wymagania przekraczają dostępne VPS, rozważ dedykowany sprzęt zamiast wnioskować z nazwy większego planu.
Dopasuj obciążenie SQL do konfiguracji początkowej
Zależnie od zgodności użyj PostgreSQL 16, MySQL 8.4 z InnoDB lub MariaDB 11.4 z InnoDB jako alternatywnych przykładów. Silniki nie są zamienne i nie są przedstawiane jako najnowsze. Przed testem zapisz wersję poprawkową; przykłady nie określają wersji obrazu dostawcy.
Umieść małą aplikację i bazę razem
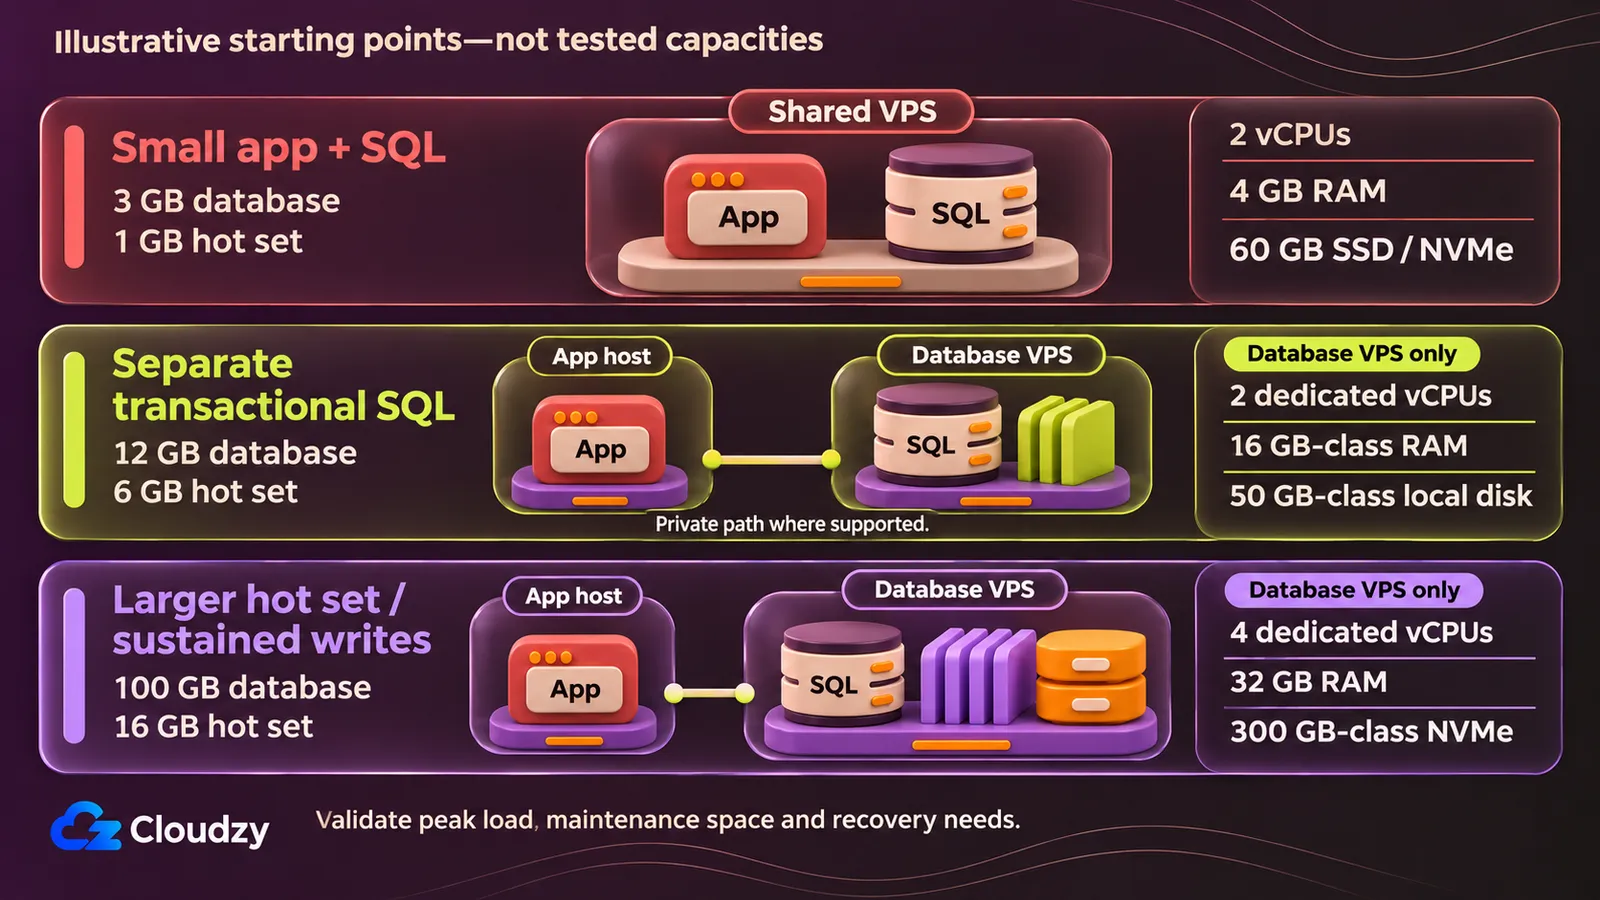
Dla założonych 3 GB danych, 1 GB gorącego zbioru i pięciu aktywnych prostych zapytań indeksowanych testuj 2 vCPU, 4 GB RAM i nominalnie 60 GB SSD/NVMe. Połączenie pozostaje lokalne, ale aplikacja i baza muszą zmieścić się we wspólnym szczycie pamięci.
Załóż odczyt/zapis 90/10, wzrost 1 GB miesięcznie i brak długich raportów podczas kopii. Współdzielony CPU może wystarczyć tolerancyjnemu stagingowi. Wybierz dedykowany, jeśli ciągła konkurencja psuje odpowiedzi; porównanie produkcyjne poniżej używa tylko dedykowanych vCPU.
Proponowany budżet RAM, wszystkie liczby w GB:
| Odbiorca | Założona RAM |
|---|---|
| System i agenty monitorowania | 0.75 |
| Aplikacja w szczycie | 1 |
| Cache bazy | 1 |
| Cache systemu plików | 0.75 |
| Rezerwa na zapytania, połączenia i konserwację | 0.5 |
| Razem | 4 |
Dopasuj pulę InnoDB MySQL/MariaDB do budżetu. Procent dla dedykowanej bazy zastosowany do całego hosta zużyje RAM aplikacji. W PostgreSQL licz oddzielnie bufory współdzielone i pamięć operacji w przydziale oraz rezerwie bazy. Zmierz łączny szczyt przed akceptacją obu wariantów.
Przykład dysku: 5 GB system/logi, 3 GB dane/indeksy, 4 GB logi silnika, 3 GB tymczasowe i 6 GB wzrost; razem 21 GB. Reszta nominalna pokrywa narzut systemu plików i pracę przejściową, nie uzasadnia przechowywania kopii na głównym serwerze.
Łącz przez lokalny socket lub localhost. Testuj trwałe commity przy aktywnej aplikacji i kopii, w tym synchronizację (fsync) żądającą zapisu na trwały nośnik. Jeśli właściciel akceptuje RPO 24 godziny, czyli okno utraty, i RTO cztery godziny, czyli cel odtworzenia, zaproponuj nocną natywną kopię poza węzłem i dowiedź czasu ćwiczeniem. Przy przekroczeniu RAM, opóźnienia lub odtwarzania oddziel, powiększ lub zmień projekt po diagnozie zapytań/indeksów.
Oddziel transakcyjną bazę SQL
Przy zdalnej aplikacji przykładowe 12 GB SQL i 6 GB gorącego zbioru można zacząć testować na 2 dedykowanych vCPU, RAM klasy 16 GB i lokalnym dysku klasy 50 GB. Zakłada to 20 aktywnych zapytań indeksowanych, krótkie zapisy i mało ciągłych obliczeń; większe operacje mogą unieważnić budżet.
Załóż odczyt/zapis 90/10 i wzrost 1 GB miesięcznie przez trzy miesiące. To obciążenie referencyjne tabeli. Jednostki są różne: porównaj realnie dostępną pamięć i użyteczne bajty systemu plików przed alokacją.
Dla PostgreSQL VPS wytyczne buforów współdzielonych PostgreSQL 16 zaczynają od 25% pamięci systemu na dedykowanej bazie z co najmniej 1 GB RAM. Używany jest też cache systemu. Propozycja 16 GB: 4 GB buforów, 2 GB system/agenty, 2 GB rezerwy zapytań/połączeń/konserwacji i 8 GB cache plików/zapasu.
Rezerwa nie jest ustawieniem work_mem. Dokumentacja pamięci operacji zapytań PostgreSQL wyjaśnia, że osobne sortowania i hashe przy wielu sesjach mogą oddzielnie przydzielać RAM. Hashe używają też hash_mem_multiplier. Ograniczaj według dozwolonej współbieżności; duża wartość na operację może przekroczyć host mimo wystarczających buforów.
Dla MySQL VPS wytyczne puli buforów MySQL 8.4 Oracle zwykle zalecają 50–75% RAM z uwzględnieniem systemu i innych przydziałów. Testuj 8 GB InnoDB, resztę zostawiając innym odbiorcom i szczytom.
MariaDB wymaga innego rachunku. Jej wytyczne przydziału pamięci zaczynają od 60–70% RAM dostępnej po systemie/usługach dla głównie InnoDB. Przy 13 GB to 7,8–9,1 GB; startowe 8 GB pasuje. MyISAM lub Aria wymagają osobnego cache. Budżety silników są alternatywami, nie sumuj ich.
Dysk: 12 GB dane/indeksy + 3 GB wzrost + 5 GB system + 4 GB logi + 8 GB tymczasowe/konserwacja = 32 GB. Dysk klasy 50 GB daje około 18 GB nominalnie przed narzutem. Wymagaj przynajmniej 15 GB zmierzonego wolnego miejsca; większe logi lub przepisywanie unieważniają przykład.
Umieść aplikację i bazę blisko, z testowaną prywatną trasą, jeśli wspierana, uwierzytelnianiem, kontrolą dostępu i szyfrowaniem. Sprawdź opóźnienie zapytań/trwałych commitów przy checkpointach, flushach i kopiach. Przydziel niezależne kopie; przykład odzyskiwania poniżej rozwija projekt. Powiększ przy nasyceniu, braku miejsca lub niespełnionej odbudowie po diagnozie zapytań/indeksów.
Zaplanuj większy zbiór roboczy lub ciągłe zapisy
Dla założonych 100 GB danych i 16 GB gorącego zbioru testuj 4 dedykowane vCPU, 32 GB RAM i NVMe klasy 300 GB, z osobną aplikacją. Przykład dopuszcza 30 aktywnych mieszanych zapytań i odczyt/zapis 60/40; przed zwiększeniem mierz wykonanie i presję dysku.
Załóż 10 GB wzrostu miesięcznie przez trzy miesiące. PostgreSQL: 8 GB buforów, 4 GB system/zapytania/konserwacja i 20 GB cache plików/zapasu. Dla MySQL/MariaDB około 16 GB InnoDB jest alternatywą po rezerwach dla innych. Nie przenoś ustawień PostgreSQL.
Dysk obejmuje pracę w toku: 100 GB dane/indeksy + 30 GB wzrost + 30 GB zachowane/oczekujące logi + 60 GB największa konserwacja/praca tymczasowa + 10 GB system = 230 GB. Zostaje około 70 GB nominalnie. Większe przepisanie tabeli wymaga przeliczenia nawet przy małym dziennym wzroście.
Dokumentacja rutynowego vacuum PostgreSQL odróżnia VACUUM, udostępniające miejsce martwych wierszy, od VACUUM FULL, które zapisuje nową kopię i potrzebuje dodatkowego miejsca. Dysk niewiele większy od danych może uniemożliwić konserwację odzyskującą przestrzeń.
Mierz CPU, presję cache i fizyczne I/O osobno od opóźnienia zapisu. Uwzględnij zapisy tymczasowe i checkpoint/flush. NVMe i dedykowany CPU opisują konfigurację, nie gwarantują IOPS. Testuj ciągły transfer kopii i replikacji z bliską prywatną trasą i niezależnym magazynem odzyskiwania. Szybsze logi zmieniają retencję i sieć. Dodawaj rdzenie, RAM lub dysk według ograniczenia, nie dlatego, że następny plan zwiększa wszystko.
Dodaj zdolność odzyskiwania w produkcji
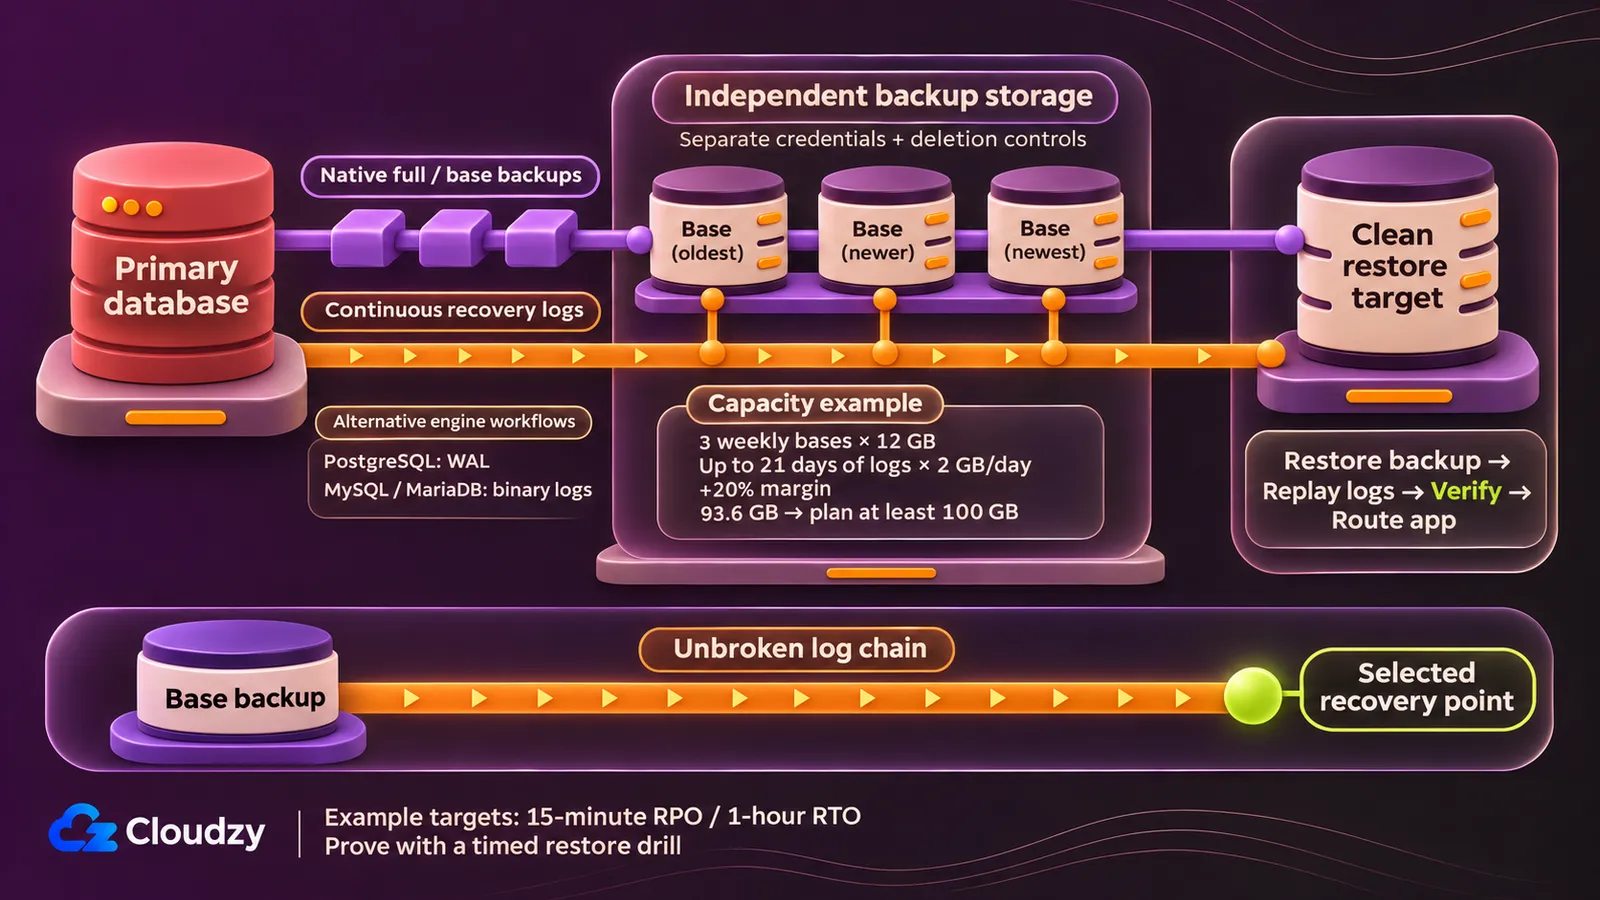
15 minut dopuszczalnej utraty i godzina na odtworzenie wymagają więcej niż budżet główny. Zachowaj oddzielne założenia SQL i dodaj natywne kopie, logi, niezależny magazyn i mierzone ćwiczenie. To cele planowania; tylko ćwiczenie dowodzi spełnienia.
Dokumentacja ciągłej archiwizacji PostgreSQL opisuje kopię bazową i nieprzerwany WAL dla odtwarzania w czasie. Dokumentacja odzyskiwania MySQL Oracle używa pełnej kopii i logów binarnych. Procedura PITR MariaDB odtwarza pełne/przyrostowe dane przed odtworzeniem logów binarnych. Dla tych procedur MySQL/MariaDB trzeba włączyć logowanie binarne.
Przykład: każda nieskompresowana pełna/bazowa kopia ma 12 GB. Zachowaj trzy tygodniowe bazy i ciągłe logi od początku najstarszej. Zaplanuj do 21 dni po 2 GB dziennie z 20% marginesem:
(3 × 12 + 21 × 2) × 1.2 = 93.6 GB
Planuj co najmniej 100 GB niezależnych kopii bez założenia kompresji. Wiąż usuwanie logów z wygaśnięciem i udanym zastąpieniem kopii. Sprawdź pełny łańcuch dla każdego obiecanego punktu odzyskania.
Użyj kopii na niezależnym celu z oddzielnymi danymi logowania i uprawnieniami kasowania. Snapshot dostawcy nie dowodzi łańcucha natywnego. Ćwiczenie ma utworzyć czysty cel, przenieść i odtworzyć kopię, zastosować logi, sprawdzić spójność bazy/aplikacji i skierować aplikację. Mierz też utworzenie i transfer.
Krótszy przestój może wymagać niezależnej repliki zdolnej obsłużyć całość. CPU, RAM i dysk licz osobno; określ promocję, odcięcie starego głównego i routing klientów. Przećwicz kolejność. Replikacja nie zastępuje kopii, a jeden VPS nie jest wysoką dostępnością. Zmień projekt przy odtwarzaniu ponad godzinę, opóźnieniu archiwum ponad RPO, słabym standby lub pełnym magazynie.
Kiedy wybrać zarządzany VPS
Jeśli nikt nie reaguje na alarmy ani nie odtwarza bazy w incydencie, kup jasno określoną obsługę operacyjną. Zarządzany VPS może przejąć konserwację, ale umowa musi wymieniać zadania bazy. Panel nie dowodzi zakresu; zarządzany VPS i baza to różne usługi.
Różnica między obowiązkami zarządzanego i niezarządzanego VPS pomaga dla każdego zadania. To lista zakupowa, nie obietnica jednakowych usług. Fizyczna infrastruktura pozostaje dostawcy; oprogramowanie gościa i baza wymagają jawnego właściciela.
| Zadanie | Niezarządzany VPS | Zakres do ustalenia przed zakupem zarządzania |
|---|---|---|
| Poprawki i aktualizacje systemu gościa i bazy | Ty planujesz i wykonujesz | Obsługiwane wersje, zakres poprawek, testy aktualizacji i okna serwisowe |
| Strojenie zapytań, schematu i indeksów | Ty diagnozujesz i zmieniasz | Czy strojenie jest w cenie, ograniczone do konfiguracji czy dodatkowo płatne |
| Monitoring i incydenty | Ty konfigurujesz alarmy i reagujesz | Godziny monitoringu, odpowiedzialność reakcji/eskalacji i kto działa po alarmie |
| Kopie i odtwarzanie | Ty odpowiadasz za procedurę odzyskiwania | Retencja, niezależny magazyn, pomoc i dowody testów odtwarzania |
Przydatne pytanie umowne: „Gdy podczas kopii zabraknie miejsca, kto diagnozuje, przywraca usługę i sprawdza następną kopię?” Oddziela dostęp do wsparcia od odpowiedzialności za wynik. Zapytaj też o nieudany upgrade i przypadkowe usunięcie.
Zarządzane bazy mają własne umowy cyklu silnika, kopii i przełączania. Mogą pasować, gdy chcesz przekazać odzyskiwanie i aktualizacje. Nie zakładaj strojenia aplikacji po nazwie; projekt zapytań i aplikacja nadal potrzebują właściciela, o ile umowa nie mówi inaczej.
Przypisz każde zadanie raz z eskalacją i kontrolą odbioru. Porównaj cenę z własnym czasem i dostępnością. Samodzielna obsługa nie ma uniwersalnej stawki, a tani serwer nie obsłuży incydentu bez odpowiedzialnego.
Wybierz VPS dla obciążeń innych niż SQL
Przykłady rozdzielają pamięć, dokumenty i wyszukiwanie. Zbliż aplikację i sprawdź połączenia oraz transfery do kopii i używanych replik.
| Obciążenie i założenia | Konfiguracja początkowa do testu | Dysk, odtwarzanie i przesłanki zmiany |
|---|---|---|
| Redis cache/klucz-wartość; zmierzone 2 GB danych | 2 dedykowane vCPU, 8 GB RAM; ustaw maxmemory poniżej RAM hosta z rezerwą narzutu |
Odbudowywalny cache dopuszcza utratę. Trwały główny wymaga świadomych RDB/AOF, przestrzeni przepisania i niezależnych kopii. Mierz RAM/RSS, fragmentację, usunięcia z cache, szczyty trwałości i skrajne opóźnienia. |
| MongoDB; 20 GB dokumentów/indeksów i mały zmierzony gorący zbiór | 2–4 dedykowane vCPU, 16 GB RAM, lokalny dysk klasy 100 GB | Licz journal/oplog, wzrost i tymczasowe miejsce. Testuj odzyskiwanie; śledź usuwanie z cache, I/O i opóźnienie replikacji. Zasoby każdej repliki licz według roli. |
| Elasticsearch; mały indeks 30 GB | 4 dedykowane vCPU, 16 GB RAM i około 150 GB lokalnie na właściwy węzeł danych | Licz repliki, scalanie segmentów, retencję i niezależne snapshoty. Sprawdzaj heap/GC, opóźnienia wyszukiwania/indeksowania, I/O scalania i dysk. Odporność wymaga topologii głosowania i routingu. |
Wytyczne administracji Redis ostrzegają, że zapis RDB lub przepisanie AOF przy intensywnych zapisach może zużyć dwa razy zwykłą pamięć zależnie od zmienionych stron. 2 GB danych nie może zająć wszystkiego. Dokumentacja trwałości rozróżnia okresowe snapshoty RDB i log AOF. Wybierz według akceptowanej straty i mierz szczyt RAM/dysku podczas działania.
Dokumentacja cache WiredTiger MongoDB opisuje cache wewnętrzny i plikowy. Domyślnie jest to większa z 50% × (RAM − 1 GB) oraz 0,256 GB. Wytyczne replica set zalecają trzech członków z danymi. Arbiter głosuje, lecz nie trzyma danych. Zaplanuj niezależne kopie i uwierzytelnianie MongoDB przed połączeniem aplikacji.
Dokumentacja ustawień JVM Elastic zaleca automatyczny heap. Ręcznie ustaw równe minimum/maksimum i nie więcej niż 50% dostępnej RAM. Wytyczne odporności małych klastrów opisują dwa węzły danych zdolne być masterem i rozstrzygający tylko głosujący. Skonfiguruj repliki i klientów do węzłów danych; rozstrzygający dodaje głos, nie kopię. Gdy scalanie/retencja zużyje zapas, popraw dysk przed kolejnymi dokumentami.
Porównaj plany bez administracji dla swojej konfiguracji
Dla oddzielnego transakcyjnego SQL filtruj co najmniej 2 dedykowane vCPU, RAM klasy 16 GB i 50 GB lokalnie. Spełnienie minimum daje kandydata do testu. Różne pakiety, jednostki i zobowiązania uniemożliwiają równość sprzętu lub ranking wydajności.
Referencja: samodzielny Linux w Niemczech lub pobliskiej Europie Środkowej, małe dane i więcej RAM. Bliskość nie oznacza identycznych opóźnień. Prywatna trasa, gdzie dostępna; ceny zachowują standardową publiczną IPv4. Załóż transfer poniżej wszystkich limitów.
| Dostawca i plan bez administracji | Dedykowane vCPU / RAM / dysk lokalny | Lokalizacja i limit transferu | Cena, rozliczenie i IPv4 |
|---|---|---|---|
| Cloudzy: nasz Regular Dedicated CPU | 8 / 16 GB / 350 GB NVMe | Lokalizacje w różnych regionach świata; 10 TB | 49,98 USD/miesiąc; IPv4 i IPv6 w cenie |
| Hetzner CCX23 | 4 / 16 GB / 160 GB NVMe | EU-central NBG1/HEL1; co najmniej 20 TB w UE | Limit 86,49 EUR/miesiąc z 0,50 EUR za główną IPv4, bez VAT |
| DigitalOcean Memory-Optimized Droplet w pakiecie, Regular CPU, 1× SSD | 2 / 16 GiB / 50 GiB NVMe | Rodzina dostępna w FRA1; 4000 GiB | Limit 84 USD/miesiąc; 0,125 USD/godzinę; publiczna IPv4 w cenie |
| Vultr Optimized Cloud Compute, Memory Optimized, AMD 2 rdzenie/16 GB/100 GB | 2 / 16 384 MB / 100 GB NVMe | Frankfurt (fra); 6144 GB |
80 USD/miesiąc; 0,11 USD/godzinę; domyślna IPv4; przed budżetem potwierdź opłatę lub rabat bez IPv4 |
| Akamai/Linode G7 Dedicated 16x8 | 8 / 16 384 MB / SSD 327 680 MB (klasa 320 GB) | Frankfurt (de-fra-2) wymieniony jako dostępny; 6000 GB |
173 USD/miesiąc; 0,2595 USD/godzinę; standardowa publiczna IPv4 bez dopłaty |
Dokumentacja wyboru DigitalOcean wymienia Memory-Optimized dla SQL/NoSQL i cache. Polecam ten pakiet przy małym dysku i dużej pamięci. Optymalizacja RAM nie oznacza wyłączności SQL. Jeśli pomiary wskazują pojemność lub ciągłe zapotrzebowanie dysku, oceń Storage-Optimized osobno.
Wszystkie pięć spełnia minimum z różnymi nadwyżkami CPU/dysku. Mogą wesprzeć wzrost, ale bez testu nie dowodzą szybkości bazy. Katalog Hetzner nie gwarantuje dostępności zamówienia. Akamai dokumentuje SSD dla G7 Dedicated. Vultr Optimized Memory różni się od współdzielonego High Frequency Compute.
Nasz dedykowany przydział pasuje do samodzielnej konfiguracji w podanej cenie. Porównaj zasoby, waluty, zobowiązania i IPv4 przed oceną wartości całości.
Koszt posiadania: moc + adres + niezależny magazyn/żądania/transfer kopii + zdolność testu odtwarzania + opcjonalny standby. Nieznane opłaty nie są zerem. Zdobądź bieżące ceny odzyskiwania i sprawdź plan, lokalizację i rozbudowę przed zobowiązaniem. Nie wyliczaj faktury rocznej z zaokrąglonego miesięcznego ekwiwalentu.
Po wyborze zgodnego silnika SQL aplikacje na kliknięcie skracają instalację. PostgreSQL, MySQL i MariaDB są oddzielnymi wyborami; jeden nie instaluje trzech. Poprawki, strojenie i odzyskiwanie pozostają po Twojej stronie.
Często zadawane pytania
Czy współczynnik trafień cache PostgreSQL wskazuje wolny dysk?
Nie. Dokumentacja statystyk I/O PostgreSQL wyjaśnia, że cache systemu może obsłużyć odczyt bez dysku. Łącz trafienia z I/O systemu i czasem zapytań. Sam współczynnik nie rozróżnia opóźnienia nośnika od czytania pamięci jądra.
Czy logiczny dump PostgreSQL służy do punktowego odtwarzania przez WAL?
Nie. Wymagania ciągłej archiwizacji PostgreSQL mówią, że logiczne dumpy nie mają informacji do odtworzenia WAL. Dump przywraca uchwycony stan; WAL wymaga odpowiedniej bazy i ciągłego archiwum. Wybierz format według metody odzyskiwania.
Czy cache MongoDB w kontenerze ma używać RAM hosta?
Używaj pamięci kontenera. Wytyczne pamięci kontenerów MongoDB ostrzegają, że WiredTiger może czasem pominąć niższy limit. Ustaw cache poniżej z miejscem na inne procesy; całkowita RAM hosta może zawyżać dostępny budżet.
Dyskusja
Komentarze
Zaloguj się, aby dołączyć do dyskusji.