

Andrej Karpathy, a co-founder of OpenAI, spent a Saturday morning in March 2026 on a small side project: he had an LLM score how "digitally exposed" a few hundred U.S. occupations are, on a 0-to-10 scale. Software developers landed at 9 out of 10. The story spread fast, and by the next morning Karpathy had taken it down (it has since been restored with added disclaimers). He said it had been "wildly misinterpreted," even though the project notes explicitly warned that a high score did not mean a job would disappear.
Cara skor risiko pekerjaan AI dihitung lebih penting daripada angka utamanya sendiri. Proyek Karpathy, Goldman Sachs, Dana Moneter Internasional (IMF), dan Anthropic semuanya memakai konstruksi "paparan" yang berbeda, sehingga persentase mereka tidak bisa saling dipertukarkan.
Pekerjaan yang sama bisa mendapat skor yang sangat berbeda tergantung metode di baliknya, dan tidak satu pun ukuran ini, jika berdiri sendiri, memberi tahu apakah Anda akan kehilangan pekerjaan.
TL;DR
- Angka "risiko pekerjaan AI" yang beredar bukanlah satu metrik. Banyak yang bermula dari paparan teoretis berdasarkan kemampuan atau tugas pekerjaan, sedangkan Anthropic juga mengukur penggunaan AI yang teramati; survei pemberi kerja seperti milik World Economic Forum memakai instrumen yang lain lagi.
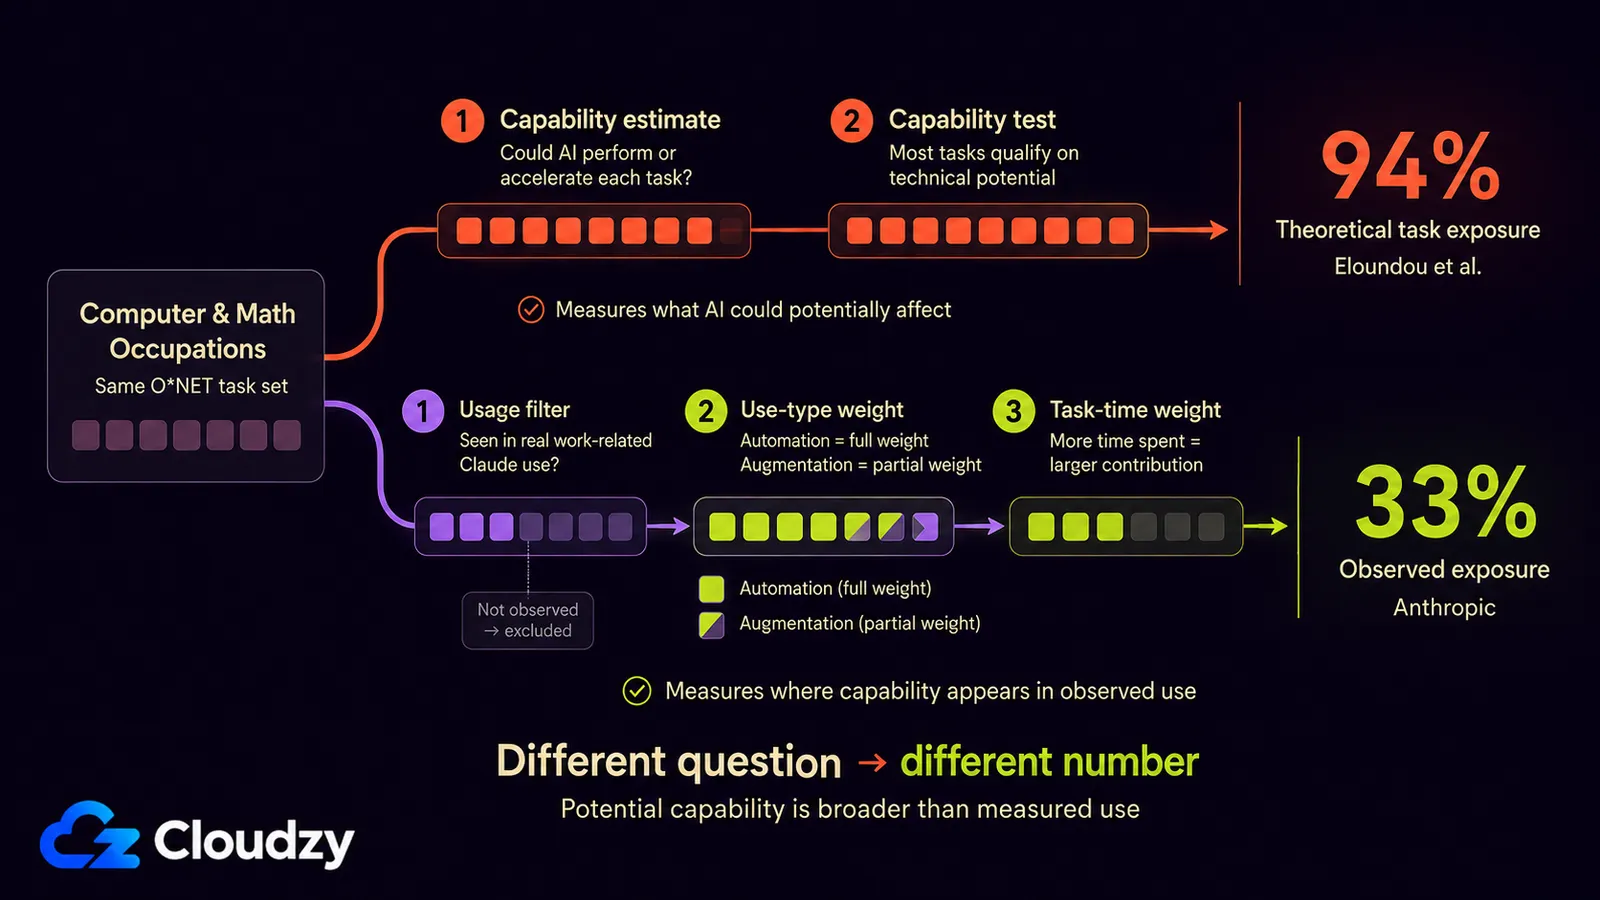
- Ukuran teoretis dan ukuran berbasis penggunaan teramati bisa sangat berbeda untuk pekerjaan yang sama. Dalam perbandingan Anthropic pada Maret 2026, ukuran teoretis Eloundou et al. menempatkan tugas Komputer dan Matematika pada paparan 94%, sementara ukuran paparan teramati Anthropic mencapai 33%.
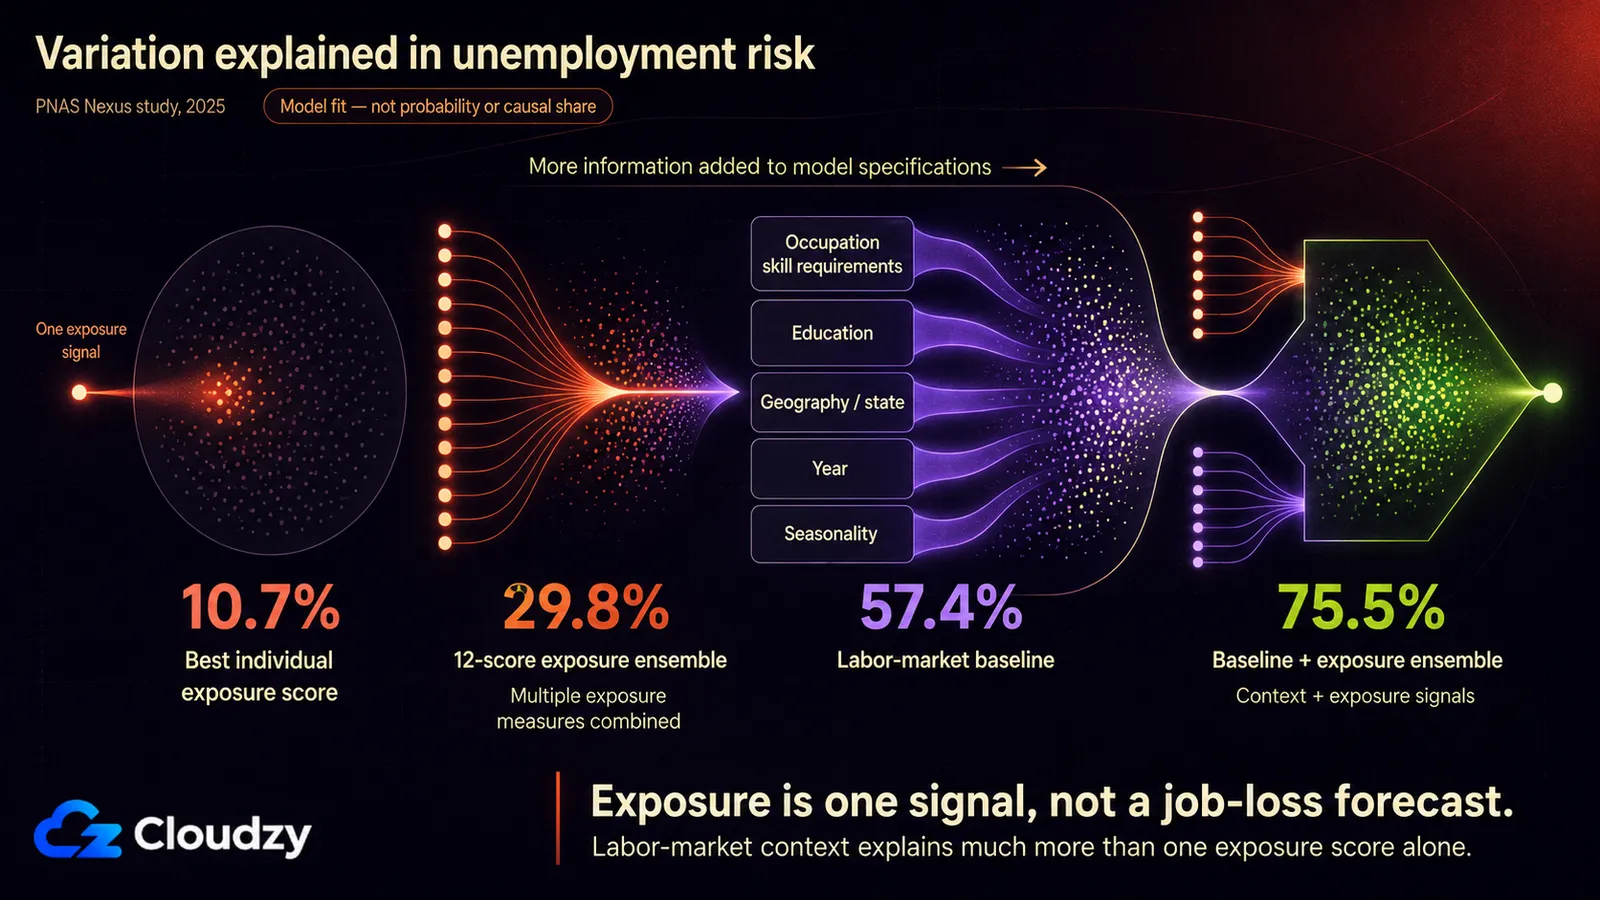
- Sebuah studi peer-review tahun 2025 di PNAS Nexus membandingkan dua belas skor paparan dengan risiko pengangguran dan menemukan bahwa skor tunggal terbaik hanya menjelaskan 10,7% variasi jika berdiri sendiri; menggabungkan kedua belasnya menaikkannya menjadi 29,8%.
- Sebelum memercayai angka "risiko pekerjaan AI" berikutnya yang Anda lihat, pertanyaan yang berguna adalah metode mana yang menghasilkannya, bukan sekadar apa kata angkanya.
Apa yang Tidak Dibahas Artikel Ini
Artikel ini menjelaskan mekanisme, bukan vonis atas pekerjaan tertentu, jadi beberapa pertanyaan terkait berada di luar cakupannya:
- Artikel ini tidak memeringkat pekerjaan mana yang paling aman atau paling berisiko. Itu jenis tulisan yang berbeda.
- Artikel ini tidak menganalisis tren perekrutan saat ini berdasarkan usia atau senioritas; hasil pasar tenaga kerja semacam itu memerlukan basis bukti yang terpisah dari skor paparan.
- Artikel ini tidak meramalkan ke mana kemampuan AI akan berkembang. Pertanyaan metodologinya tetap berlaku seberapa pun bagusnya model di masa depan.
Cara Kerja Penilaian Paparan Teoretis: O*NET, AIOE, Goldman Sachs, dan IMF
Indeks AI Occupational Exposure, yang dikenal sebagai AIOE, memadankan sepuluh kategori aplikasi AI dengan 52 kemampuan okupasional di O*NET. Sebuah matriks hasil crowdsourcing menilai seberapa terkait setiap aplikasi AI dengan setiap kemampuan manusia, lalu skornya diberi bobot berdasarkan seberapa lazim dan pentingnya kemampuan tersebut dalam suatu pekerjaan. Para ekonom Edward Felten, Manav Raj, dan Robert Seamans memublikasikan metode ini di Strategic Management Journal pada 2021. Metode ini menjadi salah satu fondasi berpengaruh bagi upaya-upaya berikutnya untuk mengukur paparan AI pada pekerjaan.
Hal penting tentang AIOE adalah ia mengukur paparan, bukan adopsi. Ia memperkirakan seberapa kuat kemajuan aplikasi AI tumpang tindih dengan kemampuan yang dibutuhkan suatu pekerjaan; ia tidak memberi tahu apakah pemberi kerja memakai AI di sana, apakah adopsinya layak secara ekonomi, atau apakah lapangan kerja akan menyusut.
IMF mengadaptasi ukuran paparan Felten, Raj, dan Seamans dalam sebuah catatan diskusi staf pada Januari 2024 dan memadukannya dengan indeks komplementaritas terpisah yang menangkap seberapa terlindungi suatu pekerjaan dari substitusi total oleh faktor seperti penilaian manusia, konteks sosial, dan kehadiran fisik. Dengan kerangka itu, IMF memperkirakan hampir 40% lapangan kerja global berada di pekerjaan berpaparan tinggi, naik menjadi sekitar 60% di ekonomi maju.
Analisis Goldman Sachs pada April 2026 mengambil langkah lanjutan serupa: menggabungkan skor pemindahan oleh AI yang sudah ada dengan indeks komplementaritas para ekonom IMF untuk memisahkan kemungkinan substitusi dari augmentasi. Goldman memperkirakan hambatan bersih sekitar 16.000 pekerjaan per bulan terhadap pertumbuhan lapangan kerja AS selama setahun terakhir, sementara pekerjaan dengan potensi augmentasi AI menambah sekitar 9.000 pekerjaan per bulan.
Catatan: Laporan Future of Jobs Report dari World Economic Forum memproyeksikan 92 juta pekerjaan tergeser dan 170 juta tercipta pada 2030, tetapi cara membangunnya sama sekali berbeda. Laporan itu berasal dari survei lebih dari 1.000 pemberi kerja yang melaporkan perubahan jumlah karyawan yang mereka perkirakan: laporan mandiri pemberi kerja, bukan penilaian berbasis dekomposisi tugas. Dua instrumen yang secara struktural berbeda akhirnya dikutip dalam kalimat "X juta pekerjaan" yang sama.
Bagaimana Anthropic Mengukur "Paparan Teramati" Secara Berbeda
Economic Index milik Anthropic, yang pertama kali diterbitkan pada Februari 2025, bermula dari jenis data yang sama sekali berbeda: sekitar satu juta percakapan nyata di Claude.ai, yang diproses melalui alat internal bernama Clio untuk memetakan setiap percakapan ke tugas tertentu di basis data O*NET yang sama dengan yang dipakai skor dekomposisi tugas, tanpa ada peneliti yang membaca obrolan aslinya. Jika AIOE bertanya apakah AI secara masuk akal bisa mengerjakan suatu tugas, Index bertanya apa yang sebenarnya diminta orang untuk dikerjakan. Laporan pertama itu membagi percakapan menjadi 57,4% augmentasi, yaitu Claude membantu sementara orang tetap mengarahkan pekerjaan, dan 42,6% otomatisasi, yaitu Claude secara efektif mengerjakan tugas dari awal sampai akhir.
Dalam laporan lanjutan Maret 2026, Anthropic mengubah data penggunaan itu menjadi ukuran "paparan teramati" yang baru. Ukuran ini bermula dari tugas O*NET dan estimasi paparan tugas teoretis dari Eloundou et al. (2023), lalu menghitung sebuah tugas sebagai tercakup hanya jika tugas itu cukup sering muncul dalam penggunaan Claude yang terkait pekerjaan. Penggunaan yang sepenuhnya otomatis mendapat bobot penuh, penggunaan augmentatif mendapat setengah bobot, dan cakupan tugas diberi bobot berdasarkan porsi waktu yang dihabiskan pekerja untuk tiap tugas. Pada pekerjaan Komputer dan Matematika, ukuran β teoretis Eloundou et al. mencapai 94% tugas, sementara ukuran paparan teramati Anthropic mencapai 33%. Selisih ini bukan kontradiksi: yang satu mengukur kelayakan teknis, yang lain menambahkan adopsi dan penggunaan yang teramati.
Tidak semua orang yang membaca laporan Anthropic sendiri menerima perbandingan itu begitu saja. Menanggapi laporan terkait pada Januari 2026, seorang komentator di Hacker News menulis: "Saya mengharapkan ukuran produktivitas ekonomi yang dihasilkan dari penggunaan kecerdasan buatan. Yang saya lihat justru ukuran penggunaan kecerdasan buatan." Ini pembedaan yang layak diingat: volume penggunaan dan produktivitas ekonomi bukan hal yang sama, dan keduanya juga bukan hal yang sama dengan hilangnya pekerjaan.
Laporan Januari 2026 itu, yakni pembaruan primitif ekonomi milik Anthropic sendiri, menunjukkan bahwa perbandingan augmentasi-otomatisasi kembali bergeser: augmentasi memimpin dengan 52% percakapan berbanding 45% otomatisasi, ditambah kerangka lima bagian yang lebih baru untuk melacak kompleksitas tugas, keterampilan, kasus penggunaan, otonomi AI, dan keberhasilan tugas. Anggap ini sebagai potret baru dari indeks yang terus berkembang, bukan kontradiksi terhadap angka Februari 2025. Pola penggunaan bergeser seiring orang menemukan hal-hal baru yang layak didelegasikan.
Angka paparan teoretis 94% dan angka paparan teramati 33% bisa menggambarkan kategori pekerjaan yang sama tanpa saling bertentangan, karena keduanya mengukur hal yang berbeda.
Mengapa "Paparan" Tidak Sama dengan "Hilangnya Pekerjaan"
"Indikator paparan mengungkap kerentanan teknologis, bukan hasil pasar tenaga kerja."
Organisasi Buruh Internasional, April 2026
Skor paparan teoretis dan skor paparan teramati sama-sama menangkap sesuatu yang nyata tentang hubungan suatu pekerjaan dengan kemampuan AI. Tak satu pun memberi tahu apakah pekerjaan itu masih ada tahun depan.
Pada 2025, Morgan Frank, Yong-Yeol Ahn, dan Esteban Moro menguji kesenjangan itu terhadap data pengangguran AS. Mereka membandingkan dua belas skor paparan yang telah dipublikasikan dengan risiko pengangguran bulanan per pekerjaan per negara bagian, yang dibangun dari catatan asuransi pengangguran negara bagian. Skor tunggal terbaik menjelaskan 10,7% variasi risiko pengangguran lintas pekerjaan, negara bagian, dan bulan; gabungan dua belas skor menjelaskan 29,8%. Model dasar yang memakai persyaratan keterampilan pekerjaan, pendidikan, negara bagian, tahun, dan musiman menjelaskan 57,4%, dan menambahkan gabungan skor paparan menaikkannya menjadi 75,5%.
Dibaca apa adanya, satu skor paparan adalah prediktor risiko pengangguran yang lemah jika berdiri sendiri. Porsi variasi yang jauh lebih besar terkait dengan struktur pasar tenaga kerja yang tidak dimuat skor tersebut, termasuk persyaratan keterampilan pekerjaan, pendidikan, geografi, dan musiman.
| Dimensi | Paparan Teoretis / Berbasis Tugas | Paparan Teramati (Anthropic) |
|---|---|---|
| Apa yang diukur | Seberapa besar bagian pekerjaan yang berpotensi dipengaruhi atau dipercepat AI | Tugas mana yang secara teoretis layak dan muncul dalam penggunaan Claude terkait pekerjaan |
| Siapa yang memakainya | Dipakai dalam beberapa kerangka paparan akademis dan institusional | Anthropic, untuk penggunaan Claude.ai miliknya sendiri |
| Sumber data | Komponen pekerjaan O*NET ditambah penilaian kemampuan AI khusus tiap metode | Penggunaan Claude ditambah tugas O*NET dan kelayakan teoretis |
| Apa yang ditangkap dengan baik | Di mana kemampuan AI berpotensi memengaruhi pekerjaan | Adopsi yang teramati dan bagaimana pekerjaan didelegasikan ke Claude |
| Apa yang terlewat | Permintaan, biaya, regulasi, dan apakah ada yang mau repot melakukannya | Penggunaan di luar Claude; mencerminkan pengguna satu produk saja |
| Contoh angka | Komputer & Matematika: 94% teoretis (Eloundou et al.) | Komputer & Matematika: 33% teramati |
Kerangka AI Jobs Transition Framework milik OpenAI pada April 2026 menyampaikan hal yang sama dari sudut berbeda. Alih-alih memperlakukan paparan teknis sebagai ramalan pemindahan, kerangka ini mengajukan tiga pertanyaan: bisakah AI mengerjakan porsi berarti dari tugas suatu pekerjaan, apakah manusia tetap sentral dalam menjalankan atau mengawasi pekerjaan, dan bisakah biaya yang lebih rendah meningkatkan permintaan cukup besar untuk menyerap kenaikan produktivitas? Diterapkan pada 921 pekerjaan yang mencakup sekitar 148 juta lapangan kerja AS, kerangka ini menempatkan sekitar 18% pekerjaan dalam kategori risiko otomatisasi lebih tinggi, 24% pada pekerjaan yang kemungkinan akan direorganisasi, 12% pada pekerjaan yang bisa tumbuh bersama AI, dan 46% pada pekerjaan yang diperkirakan mengalami lebih sedikit perubahan dalam waktu dekat.
Dalam studi PNAS Nexus, skor paparan tunggal terkuat hanya menjelaskan 10,7% variasi risiko pengangguran jika berdiri sendiri.
Jadi ketika angka "risiko pekerjaan AI" berikutnya lewat di linimasa Anda, langkah yang berguna adalah mencari tahu metode mana yang menghasilkannya sebelum memutuskan apakah perlu khawatir. Skor paparan teoretis memberi tahu di mana kemampuan AI tumpang tindih dengan komponen sebuah pekerjaan. Skor paparan teramati menambahkan bukti tentang di mana orang sudah memakai AI dalam praktik. Tak satu pun, jika berdiri sendiri, memberi tahu apakah lapangan kerja di pekerjaan itu akan naik atau turun; itu memerlukan bukti pasar tenaga kerja tentang perekrutan, permintaan, upah, dan jumlah karyawan.
Pertanyaan yang Sering Diajukan
Apakah Paparan AI pada Pekerjaan Sama dengan Hilangnya Pekerjaan?
Tidak. Paparan teoretis menggambarkan di mana kemampuan AI tumpang tindih dengan pekerjaan suatu profesi, sedangkan paparan teramati menambahkan bukti tentang di mana AI sedang dipakai dalam praktik. Tak satu pun merupakan ukuran langsung hilangnya pekerjaan. Sebuah studi peer-review tahun 2025 mengujinya secara langsung dengan membandingkan dua belas skor paparan terhadap data klaim asuransi pengangguran AS yang nyata: skor tunggal dengan kinerja terbaik hanya menjelaskan 10,7% variasi risiko pengangguran jika berdiri sendiri.
Bagaimana Risiko Pekerjaan AI Sebenarnya Dihitung?
Ada beberapa metode di balik angka yang dilabeli "risiko pekerjaan AI". Metode paparan teoretis memecah pekerjaan menjadi kemampuan atau tugas O*NET dan menilai seberapa kuat kemampuan AI tumpang tindih dengannya; metode penilaian persisnya berbeda tiap studi. Pendekatan paparan teramati Anthropic menggabungkan kelayakan tugas teoretis dengan penggunaan Claude yang nyata, konteks kerja, dan tingkat otomatisasi. Angka yang dihasilkan berbeda karena mengukur tahapan yang berbeda antara kemungkinan teknis dan adopsi di dunia nyata.
Mengapa Peringkat Risiko Pekerjaan AI yang Berbeda Tidak Sepakat tentang Pekerjaan yang Sama?
Sebagian karena dibangun di atas metode yang secara struktural berbeda (dekomposisi tugas, survei pemberi kerja, dan penggunaan teramati menjawab pertanyaan yang berbeda), dan sebagian karena satu metode pun bergeser seiring waktu. Economic Index milik Anthropic sendiri menempatkan augmentasi pada 57,4% percakapan Claude pada Februari 2025 dan 52% dalam laporan Januari 2026, dengan otomatisasi bergeser mengikutinya. Potret pada satu tanggal bukanlah hukum yang tetap.
Apakah Skor Paparan AI yang Tinggi Berarti Pekerjaan Saya Akan Hilang?
Tidak dengan sendirinya. Andrej Karpathy, yang menurunkan proyek paparan AI viralnya sendiri pada Maret 2026, menulis langsung di README proyeknya sendiri bahwa skor tersebut adalah "perkiraan kasar LLM... bukan prediksi yang ketat" dan bahwa pekerjaan berpaparan tinggi lebih sering akan "dibentuk ulang, bukan digantikan". Perbandingan Anthropic membuat perbedaan itu terlihat: di Komputer dan Matematika, ukuran teoretis Eloundou et al. mencapai 94%, sementara ukuran paparan teramati Anthropic mencapai 33%. Angka tinggi pada skala kemampuan tidak sama dengan pekerjaan yang diambil alih.



Diskusi
Komentar
Masuk untuk bergabung dalam diskusi.