

Sesuatu yang Anda bangun sudah berjalan di produksi. Monitoring Anda entah tidak ada sama sekali atau cuma ping ketersediaan, dan minggu lalu Anda tahu ada gangguan justru dari pengguna. Setiap jawaban yang Anda cari mengarah ke nama yang sama.
Ulasan Prometheus ini membahas jarak antara dua hal yang sama-sama benar. Ia gratis dan open source, tanpa lisensi dan tanpa tagihan per metrik pada skala apa pun. Ia juga menghabiskan satu malam Anda, ditambah satu bahasa kueri yang belum Anda kuasai. Ia adalah pengumpul metrik berbasis pull dengan alerting yang menempel padanya, dan ia perangkat lunak yang sangat baik. Apakah ia perangkat lunak yang tepat untuk sistem yang Anda jalankan sekarang adalah pertanyaan lain, dan itulah pertanyaan yang layak dijawab.
Versi Singkat
- Kesimpulan: 3,5 / 5 untuk self-hosting perorangan dan tim kecil. Prometheus layak dijalankan jika kumpulan host dan layanan Anda relatif stabil, Anda bersedia meluangkan waktu untuk belajar PromQL, dan Anda menginginkan metrik yang sepenuhnya milik Anda tanpa langganan dan tanpa tagihan penyimpanan.
- Lewatkan saja jika pertanyaan yang perlu Anda jawab adalah “apakah masih hidup”. Sebuah pemeriksa ketersediaan membawa Anda ke jawaban itu jauh lebih cepat, dan menarik Prometheus untuk pekerjaan itu berarti membayar sebuah bahasa kueri demi menjawab sesuatu yang bisa Anda selesaikan dalam sepuluh menit.
- PromQL adalah biaya yang terus berulang. Pemasangan adalah biaya sekali bayar. Begitu pertanyaan Anda melampaui dasbor jadi dan pembuat kueri visual Grafana, Anda kembali lagi ke PromQL.
- Biaya pemeliharaan mengikuti seberapa banyak bagian sistem yang Anda kelola secara manual. Armada yang bentuknya tetap murah untuk dipantau. Armada yang bertambah, berkurang, dan berganti nama host adalah tempat biayanya diam-diam menumpuk.
- Kesimpulan ini hanya berlaku untuk self-hosting berskala kecil. Pada skala Kubernetes dan SRE produksi, Prometheus adalah tawaran yang berbeda, dan ulasan ini tidak mencoba menjawab pertanyaan itu.
Bagaimana ulasan ini disusun: Prometheus gratis dan open source, jadi tidak ada hubungan dengan vendor mana pun di sini dan tidak ada yang mengirimi saya apa pun. Fakta tentang versi dan perilaku penyimpanan berasal dari dokumentasi resmi Prometheus. Angka penggunaan sumber daya dan waktu pemasangan berasal dari dua pengujian langsung yang diterbitkan secara independen, dan masing-masing dikreditkan tepat di tempat ia digunakan. Di titik keduanya berbeda, Anda akan melihat kedua angka alih-alih rata-ratanya.
Apa yang Dibahas Ulasan Ini
Kesimpulan di atas punya batas, dan batas itu lebih penting dari biasanya di sini, karena Prometheus berperilaku seperti alat yang berbeda pada skala yang berbeda.
- Prometheus dinilai untuk self-hosting pada satu VPS dan proyek kecil: segelintir host dan layanan, dengan satu orang yang mengurusnya.
- Bukan Kubernetes. Prometheus Operator, ServiceMonitors, dan kube-prometheus-stack adalah dunia operasional tersendiri, dan kesimpulan di sini tidak berkata apa pun tentang dunia itu.
- Bukan panduan routing Alertmanager. Alerting ada dan berfungsi; mengatur route, silence, dan receiver adalah topik tersendiri.
- Bukan panduan pemasangan. Pertanyaan di sini adalah apakah Anda perlu menjalankannya sama sekali. Kalau yang satu itu sudah Anda jawab, panduan Grafana dan Prometheus dengan Docker Compose milik kami mengulas langkah-langkahnya.
- Bukan survei exporter. Exporter hanya muncul di tempat ia mengubah jawabannya.
Apa yang Dilakukan Prometheus dengan Benar
Prometheus tidak memungut biaya apa pun. Bukan “paket gratis dengan peningkatan berbayar”, bukan pula “gratis sampai Anda melewati batas metrik”. Repositorinya berlisensi Apache 2.0 dari ujung ke ujung, tidak ada edisi berbayar untuk proyek intinya, dan tidak ada penagihan per host, per metrik, atau per label di mana pun. Satu-satunya tagihan yang pernah dihasilkan Prometheus adalah server tempat ia berjalan.
Untuk sesuatu yang akan Anda andalkan, “apakah ini masih ada tiga tahun lagi” adalah pertanyaan yang wajar, dan di sini peluangnya kira-kira sebaik yang bisa diharapkan dari open source. Prometheus lulus dari CNCF pada Agustus 2018, menjadi proyek kedua yang pernah melakukannya, setelah Kubernetes. Rilisnya konsisten, dengan v3.13.2 yang keluar pada akhir Juli 2026, dan karena jalur rilis itu adalah jalur dukungan jangka panjang, ia menerima perbaikan bug, keamanan, dan dokumentasi selama satu tahun, jadi tetap tertambal tidak berarti harus mengejar setiap versi minor.
Model datanya adalah alasan ekosistem di sekitarnya begitu dalam. Prometheus mengambil metrik lewat HTTP dan mengidentifikasi setiap deret dengan nama metrik ditambah label kunci/nilai, sehingga menulis sebuah exporter menjadi pekerjaan kecil. Karena itu ada exporter untuk hampir semua hal yang masuk akal Anda jalankan: metrik node, Postgres, Nginx, Redis, hingga probe blackbox untuk hal-hal yang hanya bisa dicolek dari luar.
Dan Anda memiliki apa yang dikumpulkannya, dan itulah bagian yang biasanya baru terasa penting belakangan, bukan di hari pertama. Riwayat sistem kecil memakan ruang disk yang tidak seberapa (angkanya di bawah), tidak ada yang bisa mengubah harganya kuartal depan, dan tidak ada baris tagihan yang membesar setiap kali seseorang menambahkan instrumentasi ke sebuah aplikasi. Kalau Anda pernah melihat tagihan monitoring terkelola merangkak naik gara-gara seorang pengembang menambahkan satu label, seluruh argumennya ada dalam kalimat itu.
Di Mana Prometheus Lebih Mahal daripada Kelihatannya
Sebuah pengujian dev.to atas tujuh alat monitoring pada satu VPS kecil mengukur pemasangan Prometheus saja pada 15 menit. Pasangkan dengan Grafana, seperti yang dilakukan penguji itu, karena expression browser bawaannya hanyalah tempat untuk menjalankan kueri. Pengujian yang sama menempatkan Grafana + Prometheus pada 35 menit sampai grafik pertama, dengan konfigurasi scrape YAML di tengah-tengahnya.
Menitnya adalah bagian yang murah. Yang mahal adalah PromQL. Prometheus menyimpan segalanya sebagai deret waktu yang diidentifikasi lewat nama dan label, dan PromQL tetap menjadi bahasa yang berada di bawah setiap pertanyaan yang Anda ajukan padanya. Grafana kini punya pembuat kueri visual, jadi Anda tidak harus menulis setiap kueri dengan tangan. Penilaian penguji itu sendiri tegas: PromQL luar biasa bagi orang yang hidup di dalamnya, dan dia bukan orang seperti itu. Kalau Anda belum pernah memakai bahasa kueri, sediakan lebih dari satu malam untuk itu, dan siapkan diri untuk kembali lagi setiap kali pembuat visual tidak lagi mencukupi. Dasbor yang Anda salin dari orang lain menjawab pertanyaan orang itu. Pertanyaan Anda adalah kueri yang belum Anda tulis.
Biaya ketiga adalah biaya yang baru muncul belakangan. Sebuah catatan tiga minggu dari seorang operator menjelaskan persis apa yang dituntut ketika menambahkan satu server ke sistem tujuh node: melabeli ulang, memeriksa ulang konfigurasi scrape, menyunting variabel dasbor, dan merombak kueri template supaya host baru itu muncul di daftar dropdown. Operator itu menyerah pada tumpukan ini setelah tiga minggu, karena menyimpulkan bahwa ia lebih banyak menghabiskan waktu menyetel dasbor ketimbang mengawasi infrastrukturnya.
Perhatikan pada apa biaya itu bergantung dalam sistem semacam ini: target dan dasbor yang dikelola secara manual. Menjalankan Prometheus selama dua tahun yang tenang nyaris tidak menambah biaya apa pun.
Berapa Banyak RAM dan Disk yang Sebenarnya Dibutuhkan Prometheus?
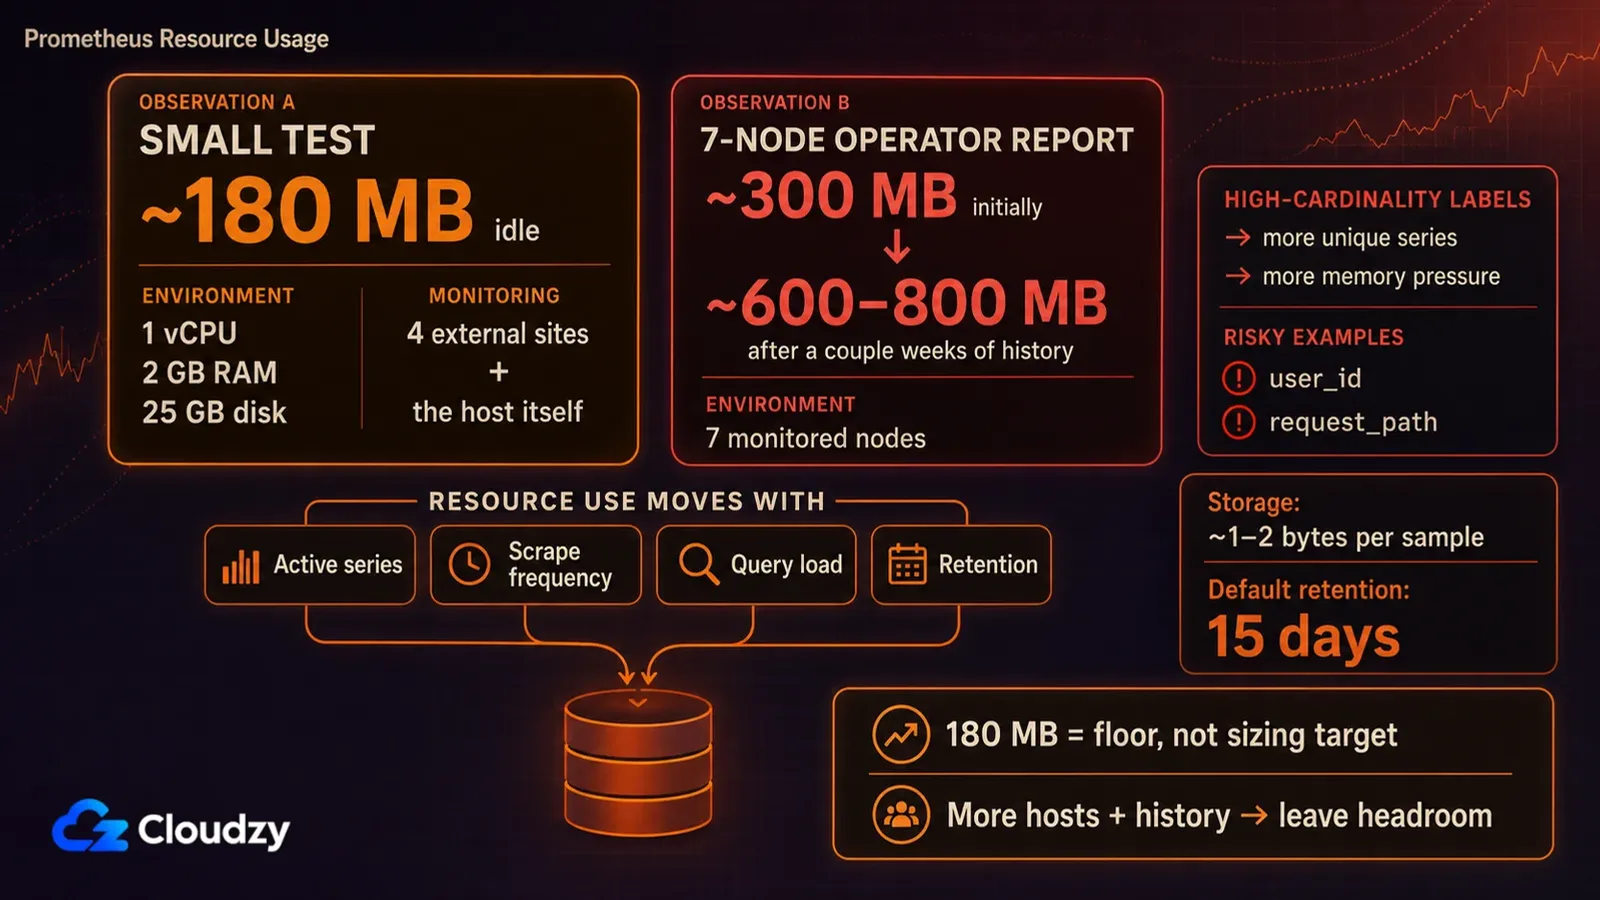
Tidak ada kebutuhan yang pasti. Deret aktif, frekuensi scrape, beban kueri, dan masa penyimpanan lebih menentukan daripada sekadar jumlah server yang Anda arahkan padanya. Dua pengujian langsung yang diterbitkan atas sistem kecil menempatkannya di kisaran 180 MB hingga 800 MB, dengan angka tertinggi mencakup tujuh node berikut riwayat beberapa minggu.
Kedua pengujian itu berbeda, dan justru perbedaannya yang berguna. Perbandingan tujuh alat pada VPS yang sama menjalankan setiap alat di perangkat keras yang identik (1 vCPU, RAM 2 GB, disk 25 GB, Ubuntu 24.04) sambil mengawasi empat situs eksternal ditambah host itu sendiri, dan mengukur Prometheus di sekitar 180 MB saat diam. Operator yang sama melaporkan Prometheus sendirian berada di sekitar 300 MB saat diam pada host pusat, lalu naik ke arah 600 sampai 800 MB begitu riwayat beberapa minggu menumpuk.
Keduanya bukan pengukuran yang sama, dan karena itulah merata-ratakannya sama saja dengan membuang informasi. Yang satu adalah pembacaan nyaris diam pada mesin yang sangat sedikit menyimpan. Yang lain adalah penerapan nyata dengan armada di belakangnya dan riwayat di disk. Bacaan saya: perlakukan hasil 180 MB sebagai lantai, bukan target penentuan ukuran. Begitu Anda mengumpulkan dari banyak host dan menyimpan riwayat, sisakan ruang alih-alih merencanakan berdasarkan angka diam itu.
Disk adalah separuh yang mudah. Dokumentasi penyimpanan Prometheus menaruhnya pada rata-rata 1 sampai 2 byte per sampel, jadi menyimpan riwayat panjang untuk sistem kecil itu murah. Jebakannya ada di nilai bawaan: masa penyimpanan bawaannya adalah 15 hari kecuali Anda menetapkan waktu penyimpanan atau ukuran penyimpanan. Jaraknya dengan setahun penuh hanyalah satu flag saat start, dan ini jenis nilai bawaan yang lebih baik Anda ketahui sekarang daripada saat pertama kali Anda mencari angka bulan lalu lalu mendapati semuanya kedaluwarsa tiga minggu yang lalu.
Yang mendorong angka memori naik adalah kardinalitas: jumlah deret waktu yang berbeda, di mana setiap kombinasi label yang unik pada sebuah metrik menjadi deretnya sendiri. Satu label yang salah pilih pada metrik bertrafik tinggi bisa menciptakan lebih banyak deret daripada lima server tambahan, dan ia melakukannya diam-diam, dengan laju sesuai trafik Anda saat itu. (ID pengguna atau path permintaan tampak seperti label yang bagus, sampai Anda menghitung ada berapa banyak nilainya.)
Angka RAM mana pun yang Anda temukan dikutip untuk Prometheus hanya berguna kalau Anda juga tahu ada berapa deret di belakangnya.
Apa yang Terjadi Ketika Server Prometheus Anda Mati?
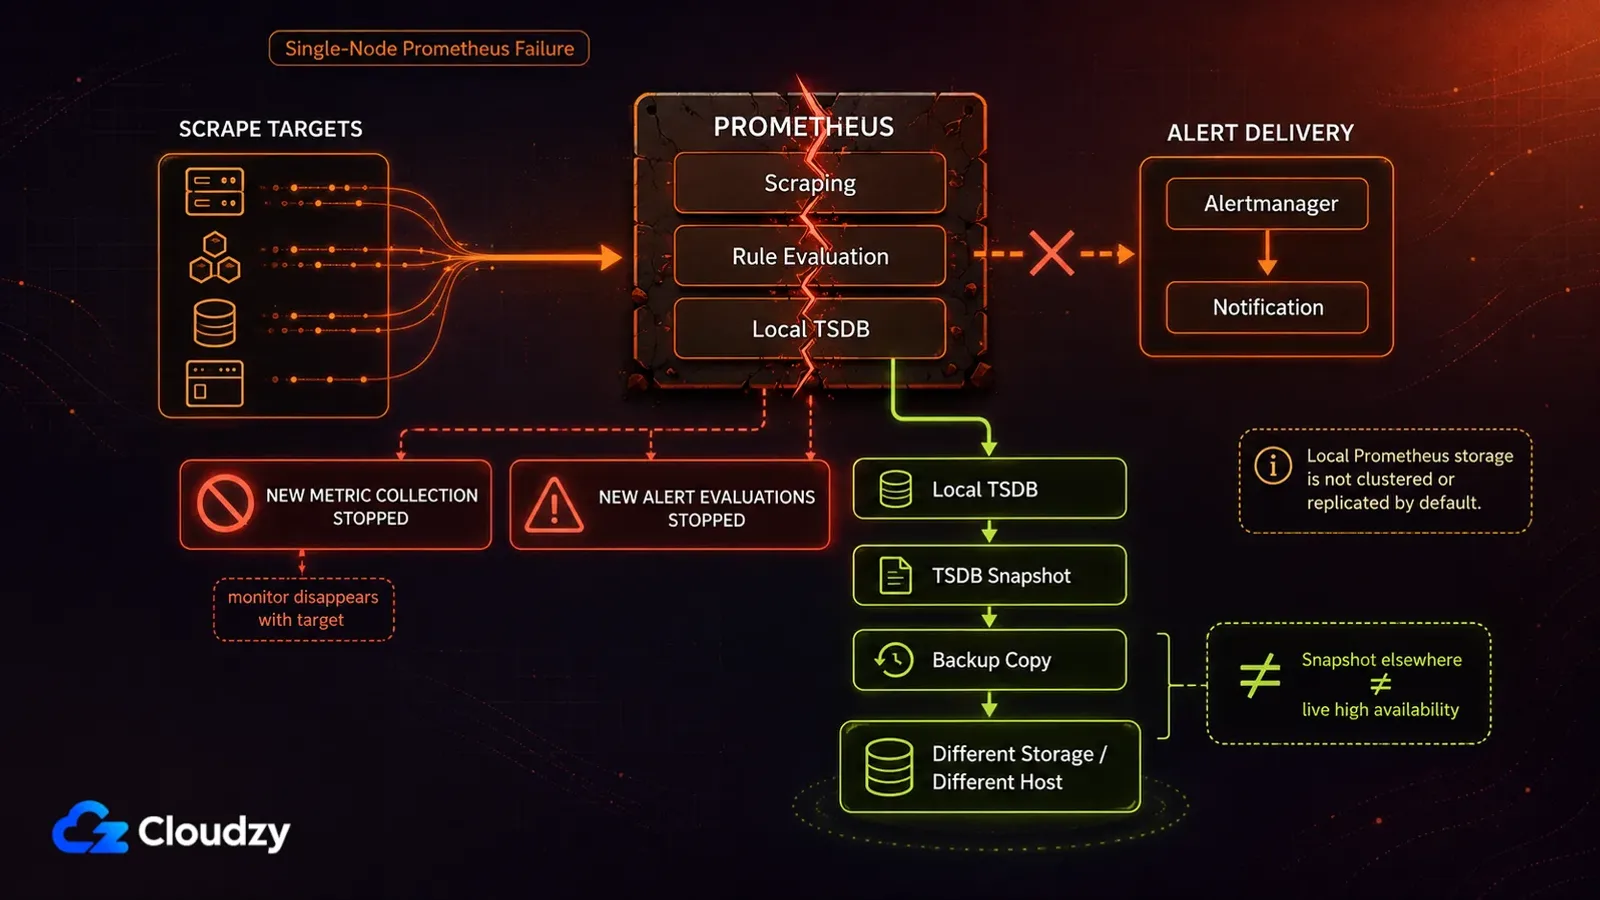
Dokumentasi penyimpanan Prometheus sendiri terus terang soal ini: penyimpanan lokal tidak dikluster maupun direplikasi, sehingga ia tidak tahan terhadap kegagalan drive atau node. Setiap server berdiri sendiri berdasarkan rancangannya dan tidak bergantung pada penyimpanan jaringan maupun layanan jarak jauh, dan justru itulah yang membuatnya mudah dijalankan sekaligus membuatnya terbuka terhadap risiko.
At solo scale that turns into two problems. If the box holding Prometheus dies, new alert evaluations stop, and your history goes with it unless you were taking TSDB snapshots and managing it like the single-node database it is, taking TSDB snapshots and copying them somewhere else. And if that box is also one of the machines being monitored, which on a one-server setup it inevitably is, then the thing that tells you something broke is the same thing that broke. (Yes, that's about as useful as it sounds.)
Ada batas kedua yang dinyatakan proyek ini tentang dirinya sendiri, dan ia pantas dipuji karena menyatakannya: kalau Anda butuh akurasi 100%, misalnya untuk penagihan per permintaan, dokumentasinya menyebut Prometheus sebagai pilihan yang keliru, karena data yang dikumpulkannya kemungkinan besar tidak cukup rinci dan tidak cukup lengkap. Pakai yang lain untuk angka yang Anda tagihkan, dan simpan Prometheus untuk monitoring. Vendor biasanya tidak menyampaikan hal semacam itu tentang dirinya sendiri.
Pada skala yang lebih besar sudah ada jawaban yang mapan untuk hal ini, dan semuanya di luar cakupan tulisan ini karena alasan yang sama dengan perkakas Kubernetes: komitmen operasionalnya berbeda dari yang dibahas ulasan ini. Untuk satu VPS, bacaan saya adalah risiko ini masih bisa diterima kalau Anda menyimpan snapshot TSDB di tempat lain atau menerima sejak awal bahwa riwayatnya akan hilang, dan ini menjadi masalah sungguhan kalau Prometheus adalah satu-satunya yang berdiri antara Anda dan gangguan yang senyap.
Siapa yang Sebaiknya Meng-host Prometheus Sendiri?
Petunjuk paling jelas bahwa Prometheus akan membayar kembali biayanya sama sekali tidak berkaitan dengan berapa banyak server yang Anda punya. Yang menentukan adalah apakah enam bulan lagi server-servernya masih yang itu-itu juga. Kumpulan host yang dikonfigurasi manual dan stabil berarti Anda menulis konfigurasinya sekali lalu mengumpulkan riwayat secara cuma-cuma; kumpulan yang terus berubah berarti Anda terus-menerus menyentuh konfigurasi itu.
Dalam sistem yang statis, konfigurasi Prometheus dan Grafana Anda adalah gambaran eksplisit dari infrastruktur Anda: target scrape, label yang menempel padanya, dan dasbor yang dibangun di atas label itu. Karena itulah riwayat adalah seluruh imbalannya. Data setahun atas kumpulan host yang stabil memberi tahu Anda seperti apa rupa keadaan normal, dan itulah cara paling andal untuk mengenali yang tidak normal sebelum berubah menjadi gangguan.
Jadi profil pertama adalah orang yang mengelola sekumpulan kecil server yang berubah perlahan dan menginginkan lebih dari sekadar hidup atau mati: latensi permintaan sepanjang waktu, tren memori, disk yang terisi cukup perlahan sehingga Anda bisa melihatnya datang berminggu-minggu sebelumnya. Kalau Anda bisa menggambarkan infrastruktur Anda hari ini dan berharap gambaran itu masih kurang lebih benar setahun lagi, malam yang Anda habiskan untuk memasangnya adalah tagihan besar yang terakhir.
Yang kedua adalah siapa pun yang sengaja mempelajari tumpukan ini. Kalau Anda memperkirakan beberapa tahun lagi masih mengurus infrastruktur, milik sendiri atau milik orang lain, malam bersama PromQL itulah yang sebetulnya Anda cari dan monitoring hanyalah efek sampingnya. Profil ini sebagian membalik yang pertama: uji kestabilan kurang penting di sini, karena waktu yang dihabiskan untuk melabeli ulang juga waktu yang dihabiskan untuk memahami apa itu pelabelan ulang. Untuk pembaca ini saya akan menaikkan nilainya.
Profil ketiga soal kepemilikan, dan inilah yang diremehkan orang sampai mereka pernah berada di sisi yang salah. Prometheus tidak menagih per host, per metrik, atau per label, dan tidak ada halaman harga yang bisa berubah di bawah kaki Anda kuartal depan. Pertukarannya dibandingkan layanan terkelola seperti Datadog: Anda melepas kehalusan, kontrak dukungan, dan jadwal siaga orang lain, dan sebagai gantinya Anda mendapat metrik yang menjadi milik Anda dengan tagihan yang tidak bergerak ketika seorang pengembang menambahkan instrumentasi. Apakah itu pertukaran yang bagus tergantung pada berapa nilai jam kerja Anda sendiri, dan hanya Anda yang bisa mengisi angka itu (dan angkanya jarang nol, bahkan ketika terasa begitu).
Satu hal yang perlu diketahui sebelum Anda memutuskan: melampaui kapasitas penyimpanan lokal Prometheus bukan jalan buntu. VictoriaMetrics menerima remote write dari Prometheus, dan MetricsQL kompatibel mundur dengan PromQL, jadi sebagian besar kueri dan dasbor Grafana yang Anda bangun sekarang mestinya selamat saat pindah. Ini migrasi, bukan penulisan ulang.
Lebih baik ditinjau ulang setahun sekali daripada diputuskan sekali untuk selamanya: sistem yang murah dipantau hari ini menjadi mahal pada kuartal ketika Anda mulai membangunnya ulang.

Bangun di VPS Linux dengan akses root, NVMe, dan tenaga AMD EPYC.
Lihat Paket LinuxSiapa yang Sebaiknya Melewatkan Prometheus?
Kalau kalimat yang akan Anda pakai untuk menggambarkan kebutuhan Anda adalah “beri tahu saya kalau situsnya mati”, yang Anda gambarkan adalah pemeriksa ketersediaan, dan Prometheus terlalu banyak mesin untuk sampai ke jawaban itu. Uptime Kuma melakukan persis pekerjaan itu lewat antarmuka web dan tidak menuntut Anda mempelajari bahasa kueri monitoring. Jurang kemampuan antara kedua alat itu sangat lebar dan sama sekali tidak relevan dengan pekerjaan yang Anda tugaskan.
Pembaca kedua adalah orang yang ingin grafik yang langsung berguna tanpa lebih dulu belajar bahasa kueri. Netdata dibangun persis untuk itu: metrik per host yang bisa langsung Anda lihat, dengan konfigurasi yang jauh lebih sedikit dan tanpa apa pun yang menghalangi antara Anda dan grafiknya. Kalau pertanyaan yang terus Anda ajukan adalah “kenapa mesin ini lambat sekarang”, itu jalan yang jauh lebih pendek menuju jawaban.
Yang ketiga adalah siapa pun yang bentuk infrastrukturnya sering berubah dan yang mengelola target serta variabel dasbor secara manual. Host yang dinyalakan seminggu lalu dihancurkan, target yang berganti nama, proyek yang berganti nama di tengah jalan. Itulah kasus ketika Anda membayar biaya konfigurasi berulang-ulang sambil memperoleh manfaat paling sedikit dari hal yang Anda bayar, yaitu riwayat berkesinambungan dari sistem yang tetap bisa dikenali.
Tidak satu pun dari ini merupakan celaan terhadap alatnya. “Melewatkan” di sini berarti melewatkannya untuk pekerjaan ini, pada skala ini. Pada skala Kubernetes, di mana service discovery menangani sebagian besar hal yang selain itu harus Anda sambungkan manual, beberapa biaya di atas menyusut atau hilang sama sekali, dan bacaan saya atas skala itu adalah Prometheus sangat sulit dikalahkan di sana. Itu ulasan yang lain.

Pertanyaan yang Sering Diajukan
Apakah Prometheus Gratis?
Ya, dan tidak ada jebakan paket gratis di baliknya. Prometheus berlisensi Apache 2.0 tanpa edisi komersial di belakangnya, jadi tidak ada kuota metrik yang harus dilewati dan tidak ada ajakan peningkatan yang menunggu di seberang. Anda membayar infrastruktur dan waktu Anda sendiri, bukan lisensi Prometheus.
Apakah Prometheus Membutuhkan Grafana?
Tidak, tetapi rencanakan saja untuk memakainya. Expression browser bawaan Prometheus ada untuk menjalankan satu kueri dan melihat jawabannya, dan itu cukup untuk memeriksa satu hal satu kali. Apa pun yang ingin Anda biarkan terbuka di monitor kedua adalah pekerjaan Grafana, dan keduanya hampir selalu dijalankan bersama.
Apakah Prometheus Berlebihan untuk Satu Server?
Sering kali ya. Kalau yang Anda perlukan adalah mengetahui apakah server dan layanannya masih hidup, sebuah pemeriksa ketersediaan menjawabnya dalam sebagian kecil waktu pemasangan. Prometheus baru pantas mendapat tempatnya ketika Anda menginginkan metrik historis yang bisa dikueri, dan Anda bersedia belajar PromQL untuk menjangkaunya.
Berapa Lama Prometheus Menyimpan Metrik secara Bawaan?
15 hari, dan ia tidak memperingatkan Anda lebih dulu. Prometheus membuang sampel yang lebih tua dari jendela penyimpanan kecuali Anda menaikkannya dengan flag waktu penyimpanan atau ukuran penyimpanan saat start. Aturlah pada hari Anda memasangnya, karena melebarkan jendela belakangan tidak akan mengembalikan data yang sudah kedaluwarsa.



Diskusi
Komentar
Masuk untuk bergabung dalam diskusi.