

Andrej Karpathy, a co-founder of OpenAI, spent a Saturday morning in March 2026 on a small side project: he had an LLM score how "digitally exposed" a few hundred U.S. occupations are, on a 0-to-10 scale. Software developers landed at 9 out of 10. The story spread fast, and by the next morning Karpathy had taken it down (it has since been restored with added disclaimers). He said it had been "wildly misinterpreted," even though the project notes explicitly warned that a high score did not mean a job would disappear.
AI 职业风险评分是怎么算出来的,比标题里的那个数字本身更重要。Karpathy 的项目、Goldman Sachs、国际货币基金组织(IMF)和 Anthropic 对“暴露度”的构建方式各不相同,所以它们的百分比不能互换使用。
同一个职业,换一种方法可能得到截然不同的分数;而这些指标没有任何一个能单独告诉你,你会不会失业。
TL;DR(太长不看版)
- 公开的“AI 职业风险”数字并不是同一个指标。很多是从基于职业能力或任务的理论暴露度出发,而 Anthropic 还测量了实际观测到的 AI 使用情况;像世界经济论坛那样的雇主调查,用的又是另一种完全不同的工具。
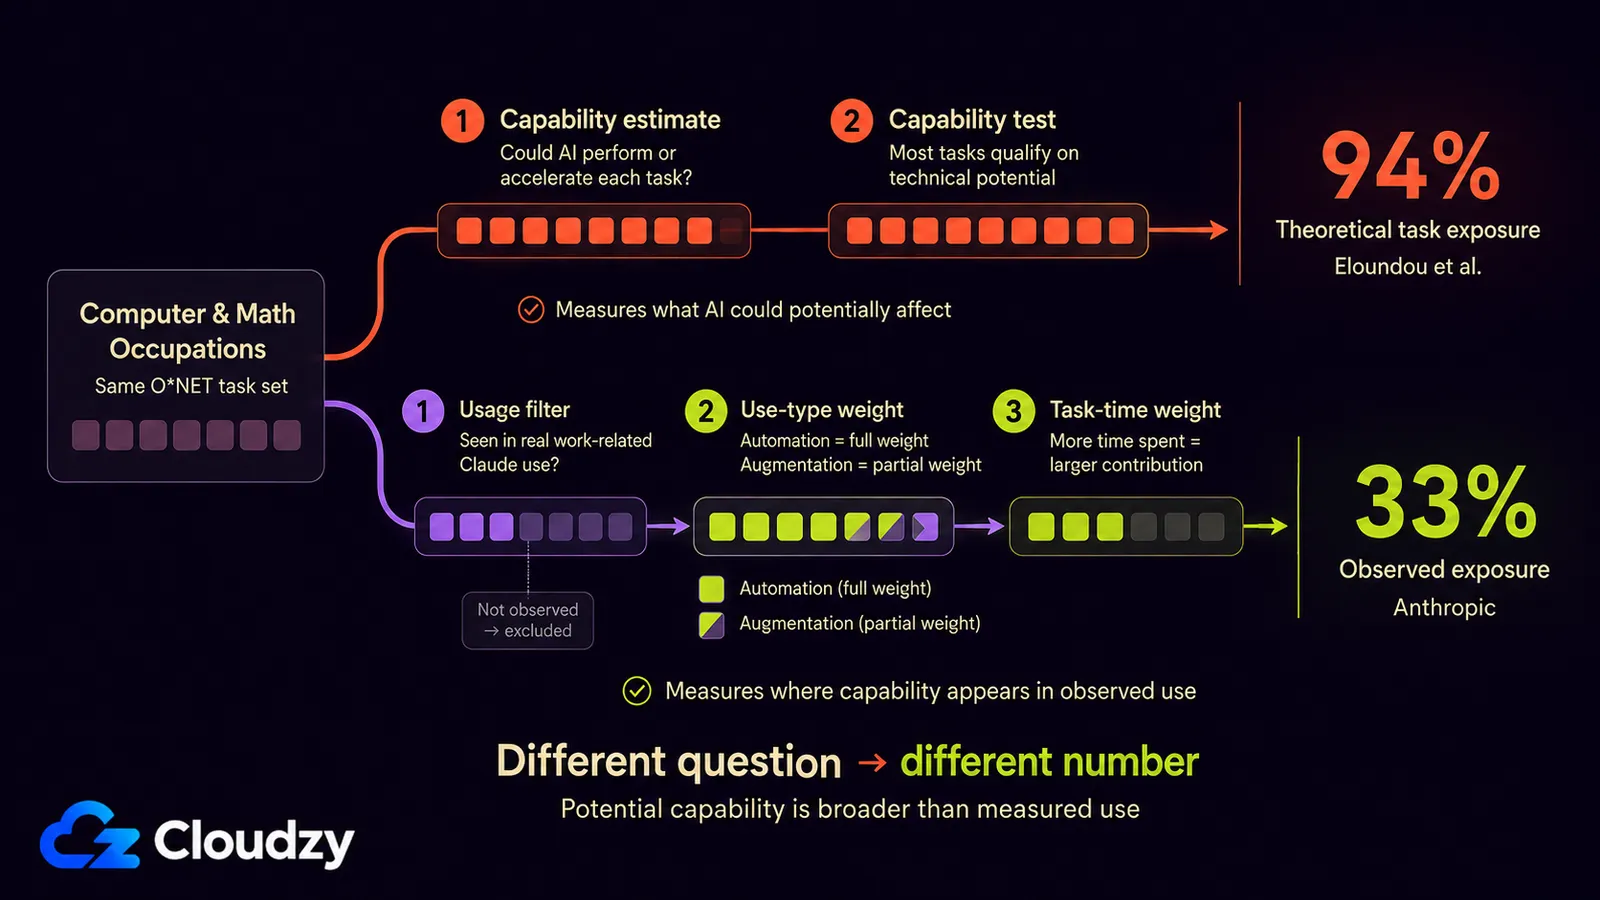
- 理论指标和基于观测使用的指标,对同一个职业可能给出差异悬殊的结果。在 Anthropic 2026 年 3 月的比较中,Eloundou et al. 的理论指标认为计算机与数学类任务的暴露度为 94%,而 Anthropic 的观测暴露度指标只有 33%。
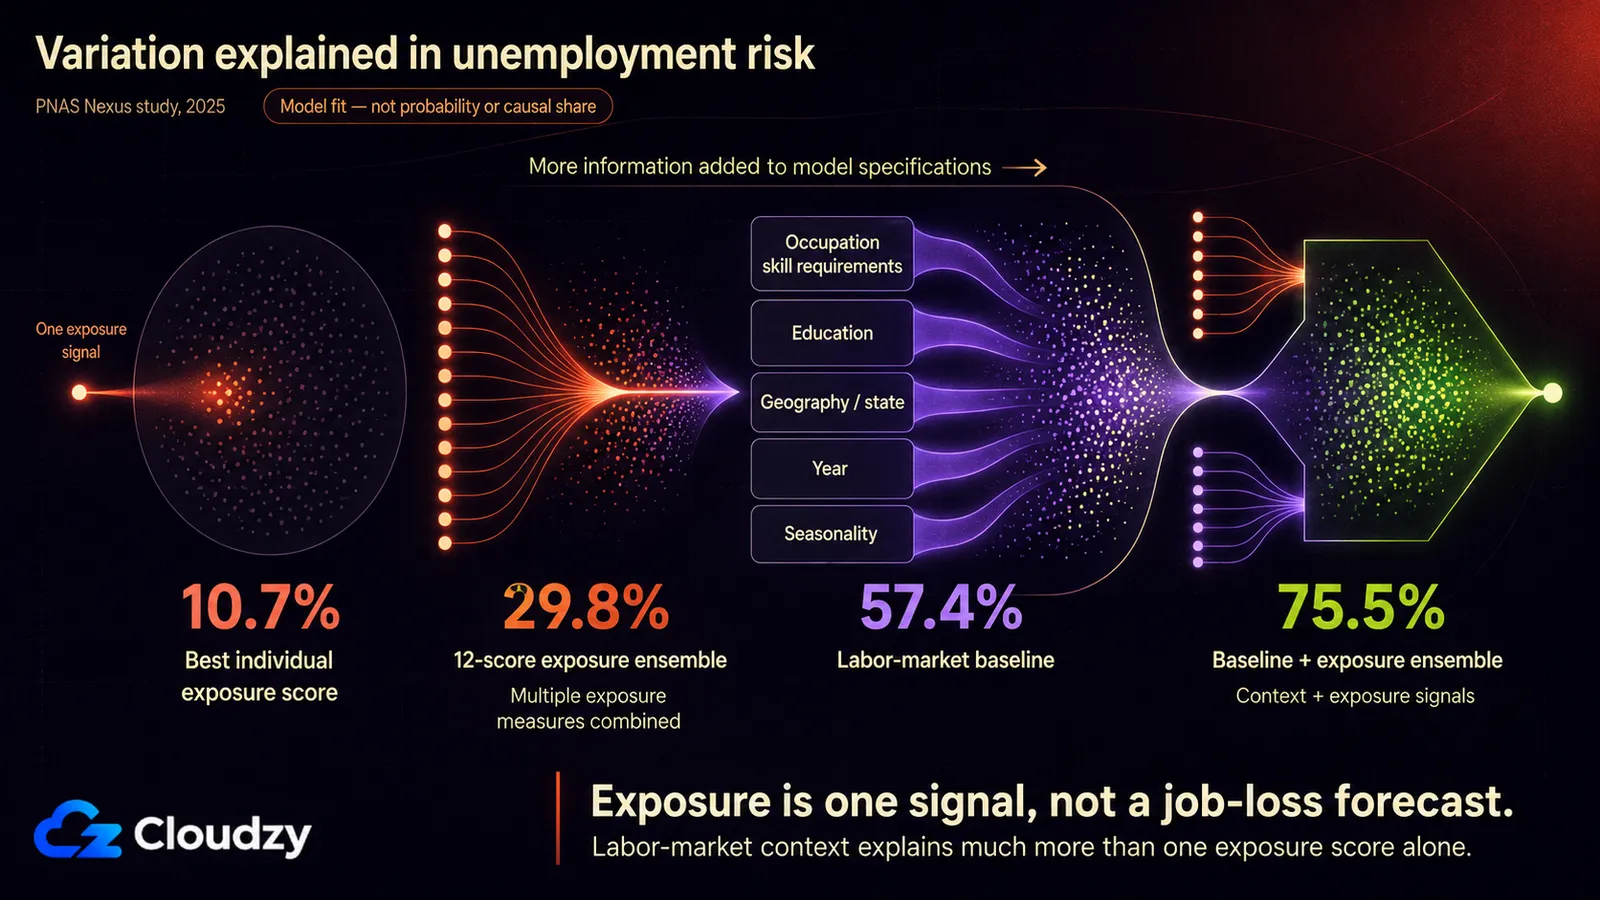
- 2025 年发表在 PNAS Nexus 上的一项同行评审研究,把十二种暴露度评分与失业风险做了比较,发现表现最好的单一评分只能单独解释 10.7% 的变异;把十二种全部组合起来,也只提高到 29.8%。
- 在相信下一个“AI 职业风险”数字之前,真正有用的问题是它由哪种方法得出,而不只是数字本身说了什么。
本文不涉及的内容
这篇文章解释的是机制,不对任何具体职业下结论,因此有几个相邻的问题不在讨论范围内:
- 它不会给职业排名,说哪些最安全、哪些风险最高。那是另一类文章。
- 它不分析当前按年龄或资历划分的招聘趋势;这类劳动力市场结果需要与暴露度评分不同的证据基础。
- 它不预测 AI 能力将走向何方。无论未来模型有多强,方法论的问题都依然成立。
理论暴露度评分如何运作:O*NET、AIOE、Goldman Sachs 与 IMF
AI Occupational Exposure 指数(简称 AIOE)把十个 AI 应用类别与 O*NET 中的 52 项职业能力交叉对照。一个众包评定的矩阵给出每种 AI 应用与每项人类能力的相关程度,然后再按这些能力在某个职业中的普遍程度和重要性对分数加权。经济学家 Edward Felten、Manav Raj 和 Robert Seamans 于 2021 年在 Strategic Management Journal 上发表了这一方法。它成为后来各种职业 AI 暴露度测量尝试的重要基础之一。
关于 AIOE,最重要的一点是它衡量的是暴露度,而不是采用率。它估算 AI 应用的进展与某个职业所需能力的重叠程度;它不会告诉你雇主是否真的在那里使用 AI、采用 AI 在经济上是否划算,也不会告诉你就业会不会下降。
IMF 在 2024 年 1 月的一份工作人员讨论报告 中采用了 Felten、Raj 和 Seamans 的暴露度指标,并配以一个独立的互补性指数,用来衡量一个职业在多大程度上因人类判断、社会情境和现场存在等因素而免于被直接替代。基于这一框架,IMF 估计全球近 40% 的就业属于高暴露职业,在发达经济体中这一比例升至约 60%。
Goldman Sachs 2026 年 4 月的分析 又向前走了类似的一步:它把此前的 AI 替代评分与 IMF 经济学家的互补性指数结合起来,以区分可能的替代和增强。Goldman 估计,过去一年 AI 对美国就业增长造成每月约 16,000 个岗位的净拖累,而具备 AI 增强潜力的职业每月新增约 9,000 个岗位。
注意: 世界经济论坛的 《Future of Jobs Report》 预测到 2030 年将有 9,200 万个岗位被取代、1.7 亿个岗位被创造,但它的构建方式完全不同。它来自对 1,000 多家雇主的调查,由雇主报告自己预期的人员变动:这是雇主的自我申报,而不是任务分解式的评分。两种结构上截然不同的工具,最后却被引用在同一句“X 百万个岗位”里。
Anthropic 如何以不同方式衡量“观测暴露度”
Anthropic 的 Economic Index于 2025 年 2 月首次发布,起点是一种完全不同的数据:大约一百万条真实的 Claude.ai 对话,通过一个名为 Clio 的内部工具处理,把每条对话映射到 O*NET 数据库中的具体任务,这与任务分解式评分所依据的是同一个数据库,且无需研究人员阅读原始聊天内容。AIOE 问的是 AI 是否有可能完成某项任务,而 Index 问的是人们实际在让它做什么。首份报告把对话分为 57.4% 的增强(Claude 提供协助,但仍由人主导工作)和 42.6% 的自动化(Claude 实际上从头到尾完成任务)。
在 2026 年 3 月的后续研究中,Anthropic 把这些使用数据转化为一个新的“观测暴露度”指标。它从 O*NET 任务和 Eloundou et al.(2023)的理论任务暴露度估计出发,只有当某项任务在与工作相关的 Claude 使用中出现得足够频繁时,才算作被覆盖。完全自动化的使用计满权重,增强型使用计一半权重,任务覆盖率再按工作者在每项任务上花费的时间占比加权。在计算机与数学类职业中,Eloundou et al. 的理论 β 指标达到任务的 94%,而 Anthropic 的观测暴露度指标为 33%。这个差距并不矛盾:一个衡量的是技术可行性,另一个则加入了观测到的采用和使用。
并非所有读过 Anthropic 报告的人都照单全收。针对 2026 年 1 月的一份相关报告, 一位 Hacker News 评论者 写道:“我以为会看到人工智能使用所产生的经济生产率的衡量指标。结果我看到的,是人工智能使用本身的衡量指标。”这个区分值得记住:使用量和经济生产率不是一回事,而两者也都不等于失业。
那份 2026 年 1 月的报告,也就是 Anthropic 自己的 经济基本要素更新,显示增强与自动化的比例再次发生了变化:增强以 52% 的对话占比领先,自动化为 45%,同时还引入了一个新的五部分框架,追踪任务复杂度、技能、使用场景、AI 自主性和任务成功率。请把它看作一个不断演进的指数的新快照,而不是对 2025 年 2 月数字的否定。随着人们发现更多值得交给 AI 的事,使用模式会不断变化。
94% 的理论暴露度和 33% 的观测暴露度可以描述同一个职业类别而互不矛盾,因为它们衡量的是不同的东西。
为什么“暴露度”不等于“失业”
“暴露度指标揭示的是技术上的易受影响程度,而不是劳动力市场的结果。”
国际劳工组织,2026 年 4 月
理论暴露度评分和观测暴露度评分,都捕捉到了某个职业与 AI 能力之间真实存在的关系。但它们都无法告诉你,这个职业明年是否还在。
2025 年, Morgan Frank、Yong-Yeol Ahn 和 Esteban Moro 用美国失业数据检验了这一差距。他们把十二种已发表的暴露度评分,与根据各州失业保险记录构建的按职业、按州的月度失业风险进行比较。最佳单一评分解释了跨职业、跨州、跨月份失业风险变异的 10.7%;十二种评分的集成解释了 29.8%。一个使用职业技能要求、教育程度、州、年份和季节性的基准模型解释了 57.4%,再加上暴露度评分集成后升至 75.5%。
直白地说,单一暴露度评分单独作为失业风险的预测指标是很弱的。变异中大得多的部分,与评分未包含的劳动力市场结构有关,包括职业技能要求、教育程度、地域和季节性。
| 维度 | 理论 / 基于任务的暴露度 | 观测暴露度(Anthropic) |
|---|---|---|
| 衡量内容 | AI 可能影响或加速一个职业中多大比例的工作 | 理论上可行的任务中,哪些出现在与工作相关的 Claude 使用中 |
| 谁在使用 | 用于多个学术和机构的暴露度框架 | Anthropic,用于其自身的 Claude.ai 使用情况 |
| 数据来源 | O*NET 职业构成要素,加上各方法自定的 AI 能力评级 | Claude 使用情况,加上 O*NET 任务和理论可行性 |
| 擅长捕捉什么 | AI 能力可能在哪些方面影响工作 | 观测到的采用情况,以及工作如何被交给 Claude |
| 遗漏了什么 | 需求、成本、监管,以及有没有人真的去做 | Claude 之外的使用;只反映一款产品的用户 |
| 示例数字 | 计算机与数学:理论 94%(Eloundou et al.) | 计算机与数学:观测 33% |
OpenAI 于 2026 年 4 月发布的 AI Jobs Transition Framework 从另一个角度说明了同样的道理。它不把技术暴露度当作替代预测,而是提出三个问题:AI 能否完成某职业中相当比例的任务?人是否仍是交付或监督工作的核心?成本降低后,需求能否增长到足以吸收生产率的提升?该框架应用于覆盖约 1.48 亿个美国岗位的 921 个职业后,把约 18% 的岗位归入自动化风险较高的类别,24% 归入可能重组的岗位,12% 归入可能随 AI 增长的岗位,46% 归入预计短期变化较小的岗位。
在 PNAS Nexus 的研究中,最强的单一暴露度评分也只能单独解释失业风险变异的 10.7%。
所以,当下一个“AI 职业风险”数字出现在你的信息流里时,有用的做法是在决定要不要担心之前,先弄清它是由哪种方法得出的。理论暴露度评分告诉你 AI 能力与一个职业的构成要素在哪些地方重叠。观测暴露度评分则补充了人们在实践中已经在哪些地方使用 AI 的证据。两者都无法单独告诉你该职业的就业会增加还是减少;那需要关于招聘、需求、工资和人员数量的劳动力市场证据。
常见问题
AI 职业暴露度等于失业吗?
不等于。理论暴露度描述 AI 能力与某职业工作内容的重叠之处,观测暴露度则补充 AI 在实践中被使用的证据。两者都不是失业的直接衡量指标。2025 年的一项同行评审研究把十二种暴露度评分与美国真实的失业保险申领数据进行对照,直接检验了这一点:表现最好的单一评分单独只能解释失业风险变异的 10.7%。
AI 职业风险究竟是怎么计算的?
贴着“AI 职业风险”标签的数字背后有多种方法。理论暴露度方法把职业拆解成 O*NET 能力或任务,再给 AI 能力与之重叠的程度打分;具体的打分方法因研究而异。Anthropic 的观测暴露度方法把理论任务可行性与真实的 Claude 使用、工作情境和自动化程度结合起来。得出的数字不同,是因为它们衡量的是从技术可能性到实际采用之间的不同阶段。
为什么不同的 AI 职业风险排名对同一职业的结论不一样?
一部分原因是它们建立在结构上不同的方法之上(任务分解、雇主调查和观测使用回答的是不同的问题),另一部分原因是即便同一种方法,也会随时间变化。Anthropic 自己的 Economic Index 在 2025 年 2 月认为增强占 Claude 对话的 57.4%,到 2026 年 1 月的报告则为 52%,自动化随之相应变动。某一天的快照并不是固定不变的定律。
AI 暴露度评分高,是不是意味着我的职业正在消失?
仅凭这一点并不能。Andrej Karpathy 在 2026 年 3 月撤下了自己那个爆红的 AI 暴露度项目,他在项目的 README 中 直接写道,这些分数是“粗略的 LLM 估计……不是严谨的预测”,高暴露度的职业更多会被“重塑,而非取代”。Anthropic 的比较让这一区别一目了然:在计算机与数学领域,Eloundou et al. 的理论指标达到 94%,而 Anthropic 的观测暴露度指标为 33%。能力量表上的高分,并不等于职业被取代。



讨论
评论
登录后参与讨论。