
假设有两个机器人:一个运行 Python,并使用本地 SQLite 数据库;另一个运行 JavaScript,负责处理命令。它们在您的笔记本电脑上都能正常工作。迁移到服务器后,还要决定如何管理依赖项、存储,以及进程失败后的处理方式。最佳 Discord 机器人托管方案取决于这些部分如何协同运行。
选择前先比较托管方案
两个都标为“1 vCPU”的方案可能采用不同的资源分配规则。先检查计算产品系列,再核对价格对应的计费周期和备份范围。共享 vCPU 与其他客户共同使用 CPU 资源;专用分配则为您的 VPS 预留 CPU 资源。活动较少的机器人也可以在共享计算资源上良好运行。
| 提供商 | 本次比较的 CPU 分配方式 | 需要核对的费用细节 |
|---|---|---|
| Cloudzy | 我们的 Regular CPU 和 High Frequency CPU 均提供专用 vCPU | 根据机器人所需资源和您偏好的计费周期比较方案价格;按小时计费的方案支持便捷调整规格 |
| DigitalOcean | Basic 使用共享 CPU;专用 CPU 系列另行提供 | Bundled Plans 包含 IPv4;备份另收费 |
| Hetzner | 成本优化型 CX23 使用共享资源 | IPv4 和备份另收费;请核对库存、位置及计税基础 |
| Vultr | 此处涉及的 Cloud Compute、High Frequency 和 High Performance 类别均使用共享 CPU | 硬件因类别而异;自动备份另收费 |
| Akamai/Linode | Shared CPU 可能出现资源争用 | 在核心区域提供;价格因区域而异 |
应在相同时间跨度内比较完整配置。如果迁移或调整部署规格,年度承诺和灵活月付会产生不同影响。将所需地址、备份服务和独立存储的费用全部计入预计支出。
根据实际工作负载选择提供商
等待事件、偶尔处理命令的机器人,与持续执行后台处理的机器人,对 CPU 的需求并不相同。根据这种行为选择计算系列,再检查整个部署的内存和磁盘需求。仅凭提供商名称无法决定这些选择。
托管与非托管 VPS 的区别也会影响购买后的工作:应明确谁负责操作系统更新、防火墙设置及应用维护。支付服务器费用并不意味着把所有运维任务都交给提供商。
Cloudzy:掌控多个机器人
如果多个机器人需要独立运行时、进程监管以及由您控制的本地存储,可选择我们的 Linux VPS。我们提供 root 权限和自行管理的环境,方便您根据应用安排 Python 和 Node.js 进程。我们的 NVMe 存储可保存机器人的本地数据库和文件。
如果部署要求对 CPU 资源的访问具有可预测性,尤其是机器人会持续执行后台工作,我们的 CPU 系列资源分配方式便适合这类需求。
我们的入门价格较低,我们的价格页面也让您能够同时选择容量和计费周期。请根据合并后的工作负载确定方案规格,并自行维护软件。
DigitalOcean:有文档可查的 VM 配置
如果明确的 Linux VM 套餐及有文档说明的计算系列选择能让容量规划更容易,可选择 DigitalOcean。其Droplet 价格页面列出的一个 Basic 配置包含 1 GiB 内存、1 vCPU、25 GiB SSD 存储和 1,000 GiB 传输量。
Basic 适合作为短时突发工作与空闲时间交替出现时的起点。如果机器人花费大量时间处理任务,应先比较专用 CPU 系列,再决定是否在 Basic 内增加规格。增加内存与改变 CPU 分配方式解决的是不同问题。选择升级前,先判断是否存在内存压力或 CPU 调度延迟。
2026 年 11 月的 Droplet 价格将该 Basic 配置的月费上限列为 $6。选择按百分比计费的每周备份后,示例计算为每月 $6 × 1.20 = $7.20,未含税费及其他费用。这仅涵盖所选服务器和备份选项,并非应用可能使用的全部服务;购买前请核对最新 Droplet 价格。
Hetzner:在合适位置运行多个轻量进程
如果多个轻量进程适合所列的 2 个 Intel/AMD vCPU、4 GB 内存和 40 GB NVMe 存储,可考虑 Hetzner 在欧洲提供的成本优化型 CX23。核查时,这款经济型 CX23 被标为不可用,因此在计划迁移前,请查看其成本优化产品页面,确认您所选位置的可用情况。
如果多个独立运行时需要内存,但大部分时间都在等待,这一配置值得考虑。若计划用于持续处理,请先检查持续的 CPU 需求。
Hetzner 的服务器文档将 Primary IPv4 地址列为每月 €0.50,不含增值税。其计费常见问题将备份费用定为服务器价格的 20%,而备份文档说明不包含附加的 Volumes。如果把数据库移到 Volume 上,应另行预算其备份费用。比较所选位置与配置时,应连同实际使用的 IP 和备份选项一起计算,并与其他报价采用相同计税基础。
Vultr:选择硬件系列
如果您有明确理由为机器人选择某个硬件系列,可选择 Vultr。其Cloud Compute 配置文档区分了使用普通 SSD 的传统 Cloud Compute、提供更高 CPU 频率和 NVMe 的 High Frequency,以及采用较新 Intel Xeon 或 AMD EPYC 处理器和 NVMe 的 High Performance。
当应用测量结果指向 CPU 运算或存储活动时,这些差异可帮助缩小选择范围。更高频率的标签不能证明 Discord 响应更快,也不会改变表中所列的资源分配类别。在为可能无法减少延迟的硬件付费之前,应将该系列与机器人中耗时的具体操作进行对照。
Vultr 的 root 或 sudo 权限及 OS/ISO 选项也适合有特定运行时需求的部署。实际好处是可以控制已安装的环境。您仍需检查依赖项和部署流程是否适用于所选操作系统;配置菜单里多一个选项并不会替您完成检查。
Vultr 的Automatic Backups 概述说明有 20% 的附加费,且不包含附加的 Block Storage。如果把机器人数据保存在这类存储上,应另行安排备份。比较账单前请检查完整的所选配置;无论硬件类别还是默认 IPv4 选项,都不能说明最终应付总额。
Akamai/Linode:现有的小型 Linux 部署
如果某个合适核心区域提供的 Shared CPU 资源能满足小型 Linux 部署,可选择 Akamai/Linode。其Shared CPU 文档列出的入门配置包含 1 vCPU、1 GB 内存和 25 GB SSD 存储。root 管理权限让您继续控制操作系统和应用设置。
文档说明的适用负载包括低至中等 CPU 需求,以及能够容忍资源争用的应用。因此,对于偶尔有突发活动的机器人,它是合理候选。若需要持续计算,请评估其他计算系列。
Akamai 区分核心计算区域和分布式计算区域,后者不提供 Shared CPU 实例。请将报价与计划部署的位置对应,并单独确认备份选项。
运行多个机器人,无需共享一切
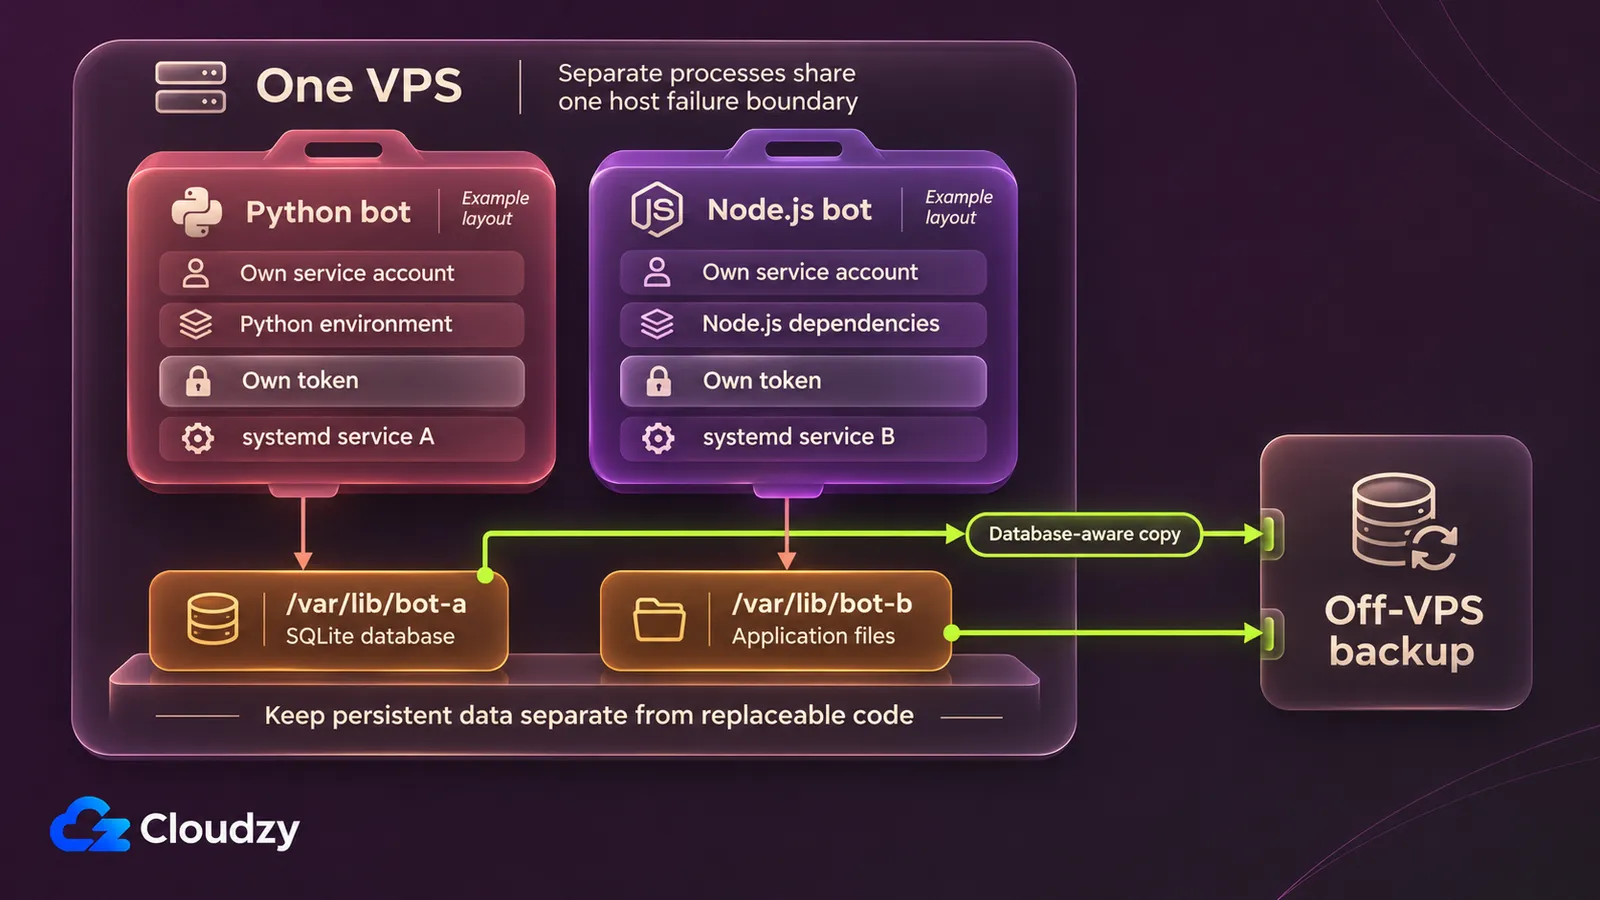
一个 Python 机器人和一个 Node.js 机器人可以在同一 VPS 上运行,同时保持依赖项、令牌和数据路径分离。为每个机器人提供独立执行环境和重启目标。root 权限让您配置主机,但应用进程本身不必以 root 身份运行。在添加更多机器人前,请有意识地将它们分开。
在一个假设的布局中,将 Python 机器人 A 的代码放在 /srv/bot-a 下,并为其配置独立 Python 环境。将 Node.js 机器人 B 的代码和依赖项安装放在 /srv/bot-b 下。为每个机器人提供独立配置文件或秘密引用,其中仅含它自己的令牌。选择不同的应用数据路径,例如 /var/lib/bot-a 和 /var/lib/bot-b,并赋予各服务账户访问所需路径的权限。这些只是建议名称,并非安装步骤。
容器是另一种隔离依赖项的方式。Docker 的资源限制文档说明,容器默认没有资源上限。观察工作负载后,应有意识地设定内存和 CPU 限制,防止某个机器人不受控制地占用主机资源预算。
同时测量多个机器人的使用情况,并计入操作系统、本地数据库和日志记录。包括安装、构建和重启时的峰值;空闲状态读数会漏掉两个应用同时繁忙的时段。VPS 所需的基础工具可作为维护和观察主机的起点。根据测量结果选择容量,而不是只看“每 GB 可运行多少机器人”的承诺或 guild 数量。两个进程仍共同处于同一主机的故障边界内。
重新部署后仍保留机器人数据
写入容器可写层的 SQLite 文件会在容器被删除时消失。Docker 的卷生命周期文档说明,保留的卷独立于使用它的容器而存在。将需持久保存的机器人数据放在明确保留的卷或主机路径中,并在重新部署前记录其位置。
将可替换代码与数据库、上传文件及机器人必须保留的其他状态分开。记录哪个进程写入各位置,以及哪些部署操作会删除它们。保留的卷在替换容器后仍存在;显式删除该卷则是另一种操作。同时设定日志保留上限,以免累积输出耗尽为应用数据预留的磁盘空间。
持久化使工作副本在部署后继续可用。备份则需要一份独立、可恢复的副本。对于正在使用的 SQLite 数据库,应选择理解数据库的方式,例如文档中的 SQLite Online Backup API。它会将在线数据库复制到另一个数据库文件中。提供商的磁盘快照本身并不能证明应用状态可被正确恢复。
将备份副本保存在 VPS 故障边界之外,并记录恢复方法。先恢复到隔离的目标位置,再检查预期记录和文件。检查一项已知的机器人保存状态,例如配置过的频道或已存储的设置。不要让恢复出的测试副本使用生产凭据连接。备份任务完成,只有与成功的恢复检查结合起来,才是有用证据。
迁移全部机器人前检查恢复能力
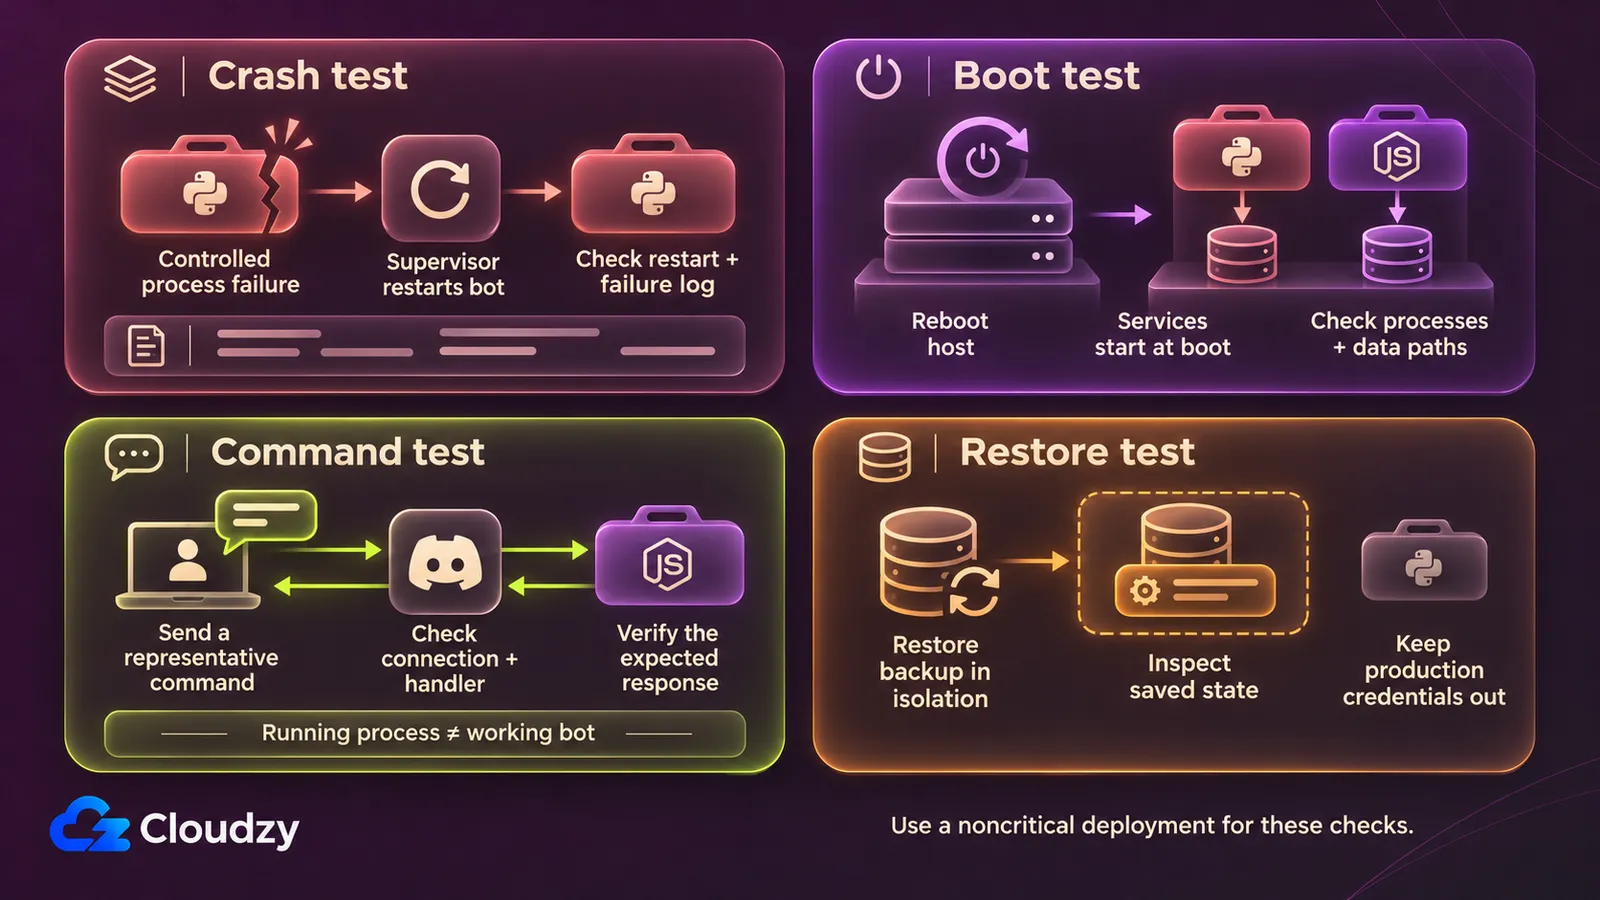
机器人进程即使仍在运行,也可能无法回应 Discord 命令。为每个进程选择一个监管程序,配置其故障和开机行为,再单独测试应用响应。原生服务、由 PM2 管理的 Node.js 进程和 Docker 容器具有不同恢复设置;仅有重启策略不能证明机器人可用。
对于原生服务,systemd 服务手册说明 Restart=on-failure 可处理符合条件的故障,包括非零退出。开机启动需单独配置。对于 Node.js,PM2 的启动文档要求配置启动集成并保存应用列表,才能在重启主机后恢复。更改 Node.js 版本后,应更新该集成。
Docker 的重启策略文档区分了 unless-stopped 与 on-failure:前者会在守护进程重启后保留主动停止状态;后者不会在守护进程重启时重启容器。让 Docker 监管自己的容器,避免主机进程管理器争相重启同一个容器。
Discord 的Gateway 连接文档要求在持久 WebSocket 连接中发送心跳并处理断连。应用或其库必须正确重新连接。基础设施可用率无法确认该连接是否健康,也无法确认机器人的命令处理程序是否正常。
迁移全部机器人前,请在非关键部署中执行以下建议验收检查:
- 制造一次受控的进程故障。确认所选监管程序会重启进程,且保留日志能解释故障。启用无人值守重启循环前,先调查反复崩溃的原因。
- 重启主机。验证预期进程已恢复,并使用预期配置和数据路径。
- 检查 Discord 连接,为每个机器人运行一条有代表性的命令。记录观察结果,而不只是进程状态。
- 执行上述隔离恢复流程,并确认应用达到预期状态。
记录这些结果并解决所有未通过的检查后,再迁移剩余机器人。
常见问题
Discord 的交互方式和数据库写入模式可能改变部署需求。
每个 Discord 机器人都需要持久连接吗?
不需要。Discord 的交互传递文档允许通过 Gateway 或 HTTP webhook 接收交互;HTTP 方式无需已连接的 Gateway 客户端。但它仍需要可访问的端点,也不能替代所有 Gateway 事件。请根据应用使用的事件选择连接模型。
多个机器人能写入同一个 SQLite 数据库吗?
可以,前提是写入能够轮流进行。SQLite 的并发指南允许多个读取者,但每个数据库文件在同一时刻只能有一个写入者。如果同时写入的任务无法排队,应考虑客户端/服务器数据库。更换 VPS 不会改变 SQLite 的写入并发模型。
更快的 VPS 能解决 Discord 交互超时吗?
不一定。Discord 的交互响应要求规定,初始响应必须在三秒内发送;交互令牌在 15 分钟内仍可用于后续响应。更换主机前,请先检查应用的响应处理。只有资源压力也是错过期限的原因时,增加 CPU 或内存才有帮助。
讨论
评论
登录后参与讨论。