
r/linuxquestions 上有位用户做了那个大家争论不休的对比。他安装了 CachyOS,在 Ryzen 7 7800X3D 搭配 Radeon RX 7900 XTX 的机器上对几款游戏做了基准测试,结果与机器上已有的其他发行版相比没有测出任何差异。回复一如既往。一位评论者把上限压得低到日常使用根本察觉不到。另一位解释了调度器。第三位说基准测试根本显示不出调度器的作用。没有人拿出能一锤定音的测量结果。
这个问题总是以同样的措辞反复出现:CachyOS 真的更快吗?简短的回答是:在特定负载下,是的。重新编译的软件包能帮助编译器可以向量化的代码;这里引用的游戏对比显示平均帧率几乎没有差距;而切换后感觉更快的系统更难归因,因为换发行版改变的远不止一个变量。
它之所以悬而未决,是因为"更快"里藏着三个各自独立的断言,三个不同的答案,每一个都需要自己的测量手段。重新编译的软件包要么用更少的实际时间完成任务,要么没有。调度器要么改变了桌面在资源争抢下的表现,要么没有。而一台更灵敏的机器,要么归功于 CachyOS,要么归功于随之而来的其他东西。
简短版本
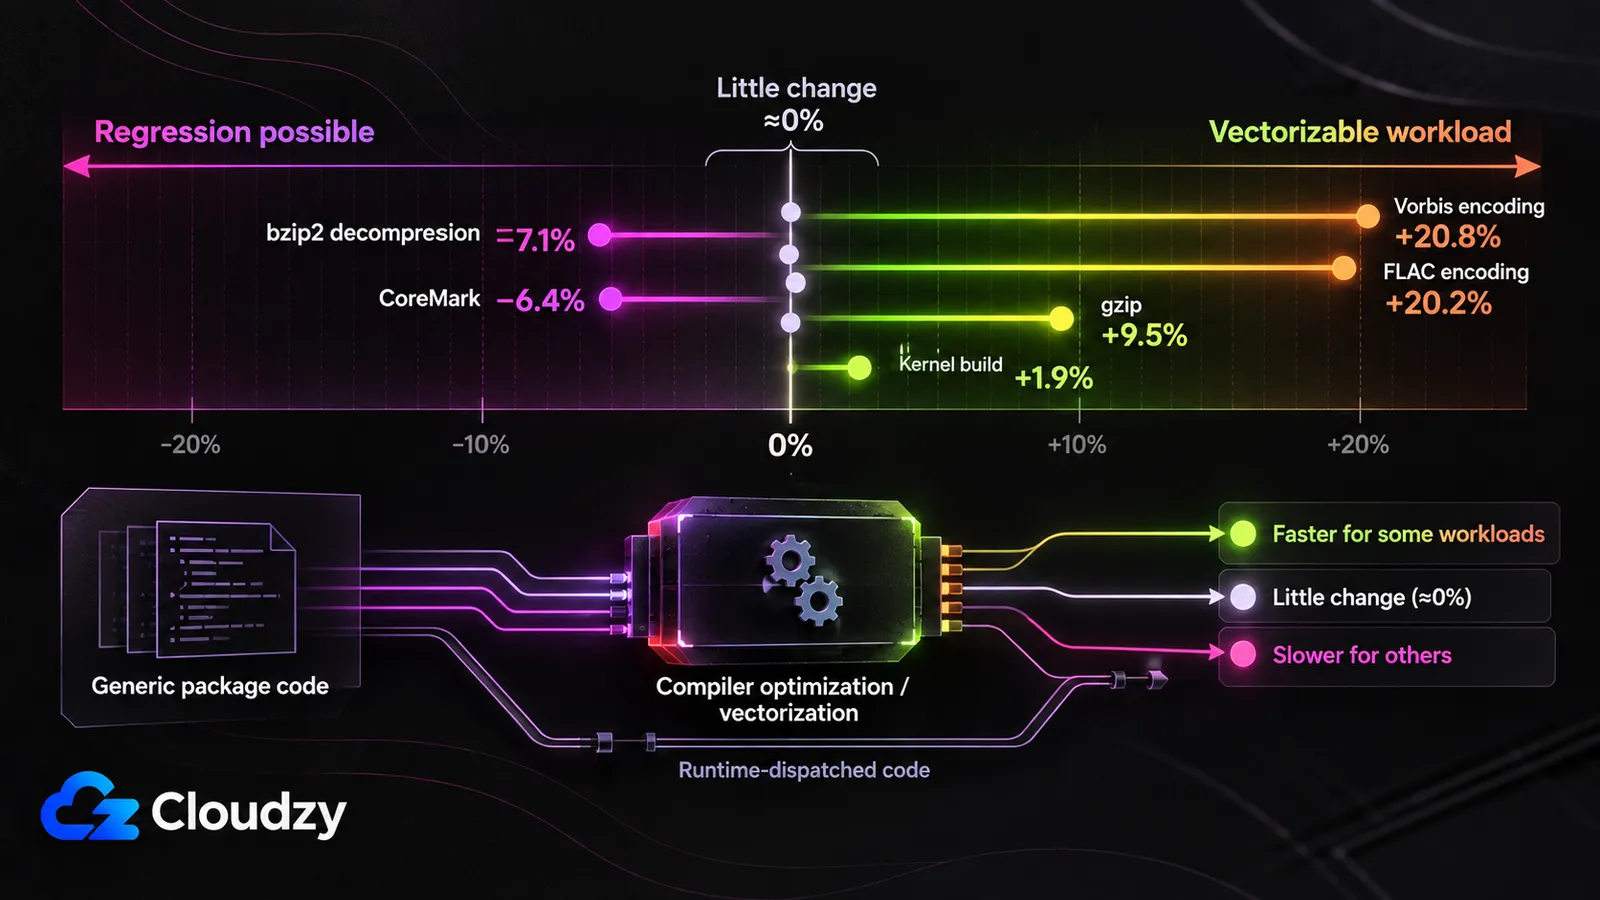
- 重新编译的软件包:可测量地更快,但只覆盖你运行的少数程序。 收益集中在编译器能向量化的代码上,好几个软件包反而变慢,大多数则没有变化。sunnyflunk.github.io 在 2023 年 1 月做的一次 arch-chroot 对比,在一台 Intel NUC8i5BEK 上,同一轮测试里发现 flac 编码快了 20.2%,而 bzip2 解压慢了 7.1%。
- 调度器的故事一分为二。 CachyOS 当前的默认内核使用 EEVDF,BORE 则单独提供。2026 年 5 月的发行版对比发现平均帧率差距很小,也测量了 1% Low 和帧间隔稳定性,但没有单独隔离 BORE,也没有加入受控的竞争 CPU 负载。开箱即用的游戏表现已被测量;BORE 在资源争抢下的收益尚未被单独验证。
- 机器更快的感觉:体验真实,归因不可靠。 全新安装,以及一个无关 bug 的偶然修复,都会带来一台更灵敏的系统,而这与指令集级别毫无关系。值得了解的例外是 Phoronix 在 Intel Core Ultra 9 285K 上的开箱即用对比:在一颗完全无法使用 AVX-512 优化的 CPU 上,CachyOS 领先了原版 Arch。
CachyOS 实际改变了你系统的哪些部分
CachyOS 是在 Arch Linux 之上叠加了三项独立的改动:一个提供替代调度器的补丁内核,一组针对更新 CPU 指令集级别重新编译的软件仓库,以及对部分核心软件包施加的额外编译器优化。每一项都是独立的机制,有独立的效果,而它们几乎从未被分开测量过。
内核这一侧是最大的一块。 CachyOS 的内核特性列表 涵盖了 Clang ThinLTO、AutoFDO 性能剖析、运行时可选的抢占模式,以及多个调度器选项。当前的 linux-cachyos 软件包使用 CachyOS 调校过的 EEVDF 作为默认调度器。BORE 和 BMQ 通过单独的内核变体提供,而 linux-cachyos-eevdf 在 EEVDF 上额外施加了响应性调校, linux-cachyos-server 则使用原版 EEVDF。sched-ext 在支持它的变体上仍然可用。
软件包这一侧,争议所在的机制是 CachyOS 的 x86-64-v3 仓库。 CachyOS 的优化仓库页面 描述了针对通用基线之上的三个目标重新构建 Arch 软件包:x86-64-v3、x86-64-v4,以及一个专门的 Zen 4/5 目标,它在 v4 之上加入了更多 AVX-512 扩展和一些 AVX-512 之外的指令。一部分对性能敏感的软件包还会获得基于性能剖析的优化和 BOLT。
这些级别名称来自 x86-64 psABI 微架构级别规范,它们是门槛,而不是旋钮。x86-64-v3 要求 2013 年随 Intel Haswell 和 AMD Excavator 核心到来的 AVX 与 AVX2 时代指令;x86-64-v4 要求 AVX-512,实际上意味着 Skylake-X 级别的 Intel 处理器以及所有 AMD Zen 4 及更新型号。一颗 CPU 要么达标,要么不达标。
"更快"一词里藏着的三个断言
当两个人对 CachyOS 是否更快意见不一时,通常他们各自在不同的事情上都是对的。吞吐量、帧稳定性和感知到的响应速度是三种不同的属性,没有哪个单一指标能同时判定三者。计时任务测的是吞吐量;帧时间和延迟测量覆盖游戏流畅度;而更广泛的系统级效果需要一次受控的全新安装对比。
| 断言 | 主张的内容 | 该如何测量 | 证据表明什么 | 可信度 |
|---|---|---|---|---|
| 实测吞吐量 | 重新编译的软件包用更短时间完成同一任务 | 在固定硬件和固定内核上给一个任务计时,只改变软件包来自哪个仓库 | 可向量化的工作收益明显,多个软件包小幅退步,大多数没有变化 | 高。Canonical、CentOS ISA SIG 和两位独立测试者在整体趋势上一致 |
| 输入延迟与帧稳定性 | 当其他东西占满 CPU 时,桌面依然保持响应 | 竞争负载下的帧时间百分位和输入延迟,而不是平均帧率 | 已发布的测试现在包含了 1% Low 和帧间隔稳定性,但没有隔离调度器,也没有引入受控的竞争 CPU 负载 | 低。机制有文档记录,测量却缺失 |
| 感知到的响应速度 | 切换后机器感觉更灵敏 | 与上一个发行版的全新安装对比,而不是用旧了的那个 | 通常可以用全新安装效应或某个偶然修复解释;一次开箱即用对比发现了发行版层面的领先 | 中。体验站得住脚,归因不可靠 |
能回答第一行的基准测试套件回答不了第二行,两者都碰不到第三行。只跑三者之一,却把结果当成对三者的裁决,这正是让这场争论一直持续的原因。
重新编译的软件包真的跑得更快吗?
是的,但只覆盖桌面所运行程序中的少数,而且幅度由负载决定,不由发行版决定。可向量化的工作能拿到两位数的收益,少数软件包反而变慢,大多数则毫无变化。CachyOS 的优化仓库页面把 x86-64-v3 相对通用 x86-64 的提升定在 5% 到 20%;已发布的实测大多落在这个区间的下端。
最干净的 CachyOS 与 Arch 性能对比只隔离了软件包这一个变量,别的什么都没动: 2023 年 1 月的一次 arch-chroot 测试 ,发布于 sunnyflunk.github.io。宿主机在 Intel NUC8i5BEK 上运行原版 Arch,两套软件包都在 arch-chroot 内测试,以保证内核和环境完全一致,基准测试则在内存中运行以消除磁盘延迟。与原版 Arch 软件包相比,CachyOS 的构建在以 -8编码 flac 时快 20.2%,编码 vorbis 快 20.8%,gzip -3快 9.5%。同一轮测试中,它们解压 bzip2 慢 7.1%,用 lz4 压缩慢 1.6% 到 2.9%,pybench 慢 3%,R 基准测试没有变化。两条附加说明来自作者本人:CachyOS 用的编译参数是 -march=x86-64-v3 -mpclmul -O3 ,而 Arch 是 -march=x86-64 -O2;他的后续测试表明,部分较大的收益来自 -O3 而非指令集级别。这篇文章早于 CachyOS 随 2024 年 7 月版本推出的 Zen 4 仓库,但并不早于其 BOLT 工作:作者认为导致 pybench 退步的 CachyOS Python 软件包当时已经在 x86-64-v3 之上叠加了 BOLT。
CachyOS 在更新硬件上的基准测试重复了同样的模式。 mvermeulen.org 在 2024 年 7 月的一次对比 在 Zen 4 架构的 Ryzen 7940HS 上运行了 Phoronix Test Suite 的一个子集,用启用 Zen 4 仓库的 CachyOS 对比 Ubuntu 22.04。大多数结果在正负几个百分点之内:coremark 慢 6.4%,OpenSSL 各子项从慢约 1% 到快 4% 不等,内核构建时间快 1.9%,phpbench 是个异常值,得分略高于两倍。作者指出 GCC 版本不一致(14.1 对比 Ubuntu 的 11.4)很可能是干扰因素。他 2024 年 3 月单独进行的 NAMD 测试 在两个分子动力学负载上分别测得 6.5% 和 5.8% 的提升。
机构级测试在两端都得到了同样喜忧参半的结果。 Canonical 自己的 x86-64-v3 基准测试于 2024 年 3 月发布,基于 Azure 上的实验性 Ubuntu 23.10 镜像,报告 glibc Log2 基准测试可复现地提升最多 60%,而其他基准测试则明显退步,其中一例是因为在已优化的 SSE 代码上启用 v3 后,编译器把它展开成了 17 倍的指令数。 CentOS ISA SIG 对 CentOS Stream 9 的重新构建 于 2023 年 8 月在 Ice Lake 级别的 Intel 机器上从 v2 升到 v3,团队称结果"相当参差":2.2 倍的加速集中在 Mocassin 和 John the Ripper 的 md5crypt 上,两者都高度依赖向量化,不过团队把 Mocassin 的收益主要归功于 GCC 12 的自动向量化,而非 ISA 级别。
许多对性能要求高的数学和密码学库都会携带热点函数的多个版本,并在运行时通过 CPU 特性检测选择其一,这种技术叫函数多版本化,在 glibc 中通过 IFUNC 解析器实现。这意味着在原版 Arch 安装上,一些热点路径无需重新构建整个软件包就已经能使用 AVX2。sunnyflunk 的文章直接观察到了这一点,指出 flac 的源码本身就包含 AVX2 运行时函数,无需 -march 即可启用。CentOS 的发现则是镜像的另一面:团队发现了 缺少 IFUNC 版本的 glibc 数学函数,而这正是静态重新构建有用武之地的地方。v3 重新构建触及的,是编译器自动向量化器能自行改进的那部分剩余代码,这只是桌面系统中的一小片。
决定机器级改动是否显现的,是负载的形态,而不是 CPU 上的标签。关于吞吐量的结论是肯定的,但有边界:上述测量中个位数的变化很常见,较大的收益集中在编码、压缩这类可向量化的负载上,而有些软件包会退步。这比把 x86-64-v3 当成全系统的速度倍增器要准确得多。
调度器改变了什么,以及为什么平均帧率看不到它
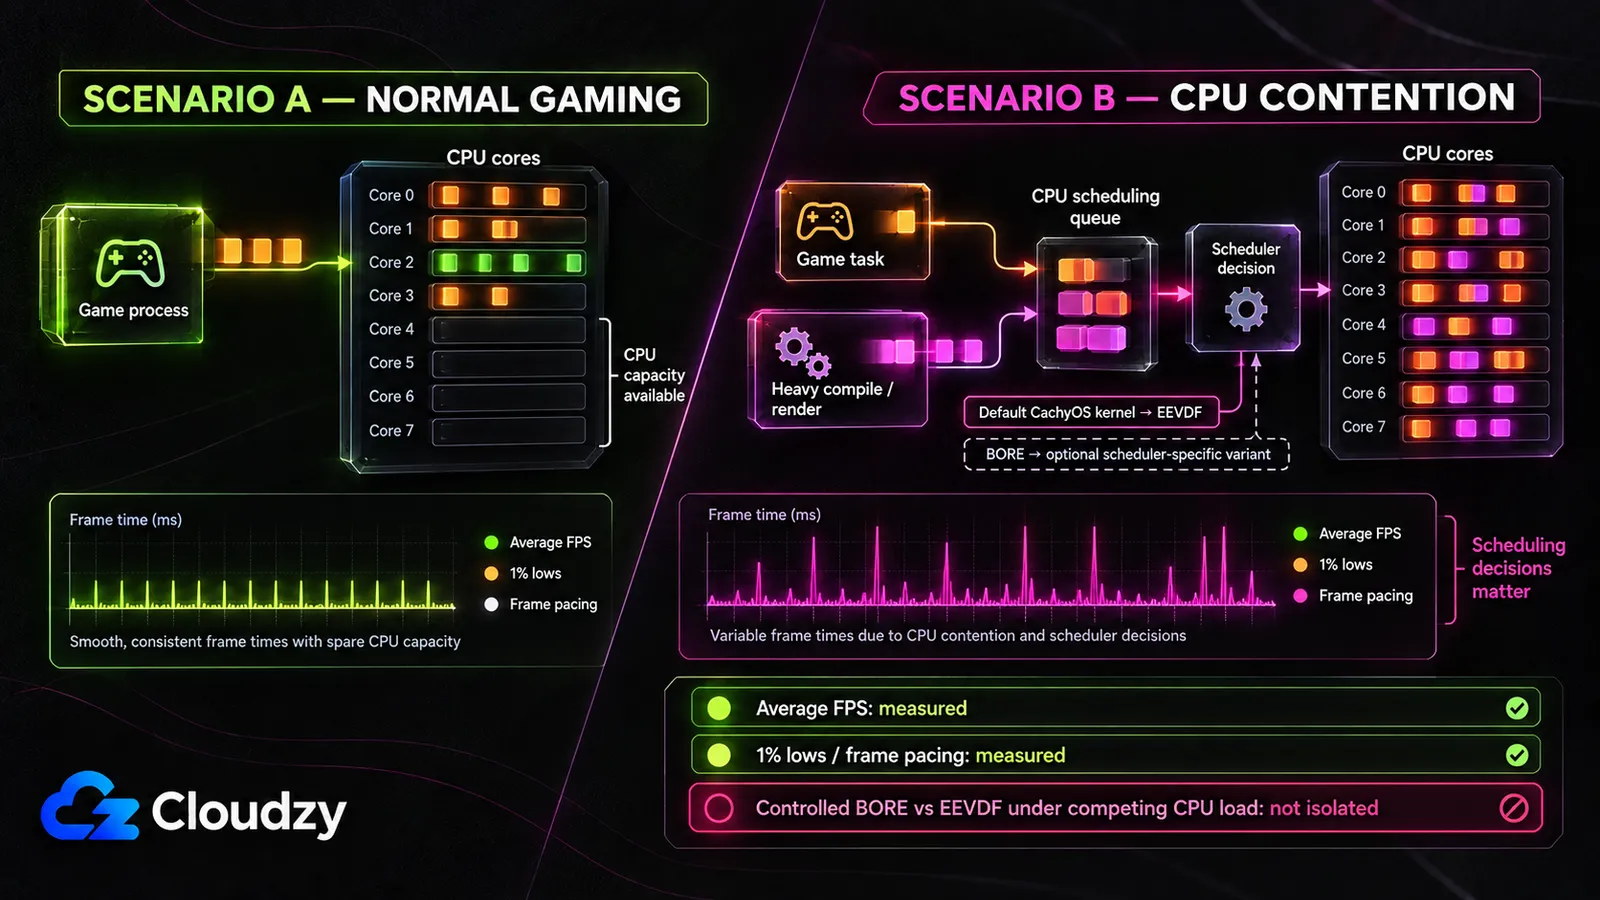
CachyOS 当前的默认 linux-cachyos 内核使用 EEVDF,而 BORE 则通过 linux-cachyos-bore这类针对特定调度器的变体提供。这一区分很重要,因为下面的游戏对比是发行版层面的测试,而不是受控的 BORE 对比 EEVDF 测试。BORE 与更宽泛的性能主张仍然相关,因为它的设计明确针对混合负载下的响应性,但这一主张必须与 CachyOS 开箱即用的游戏表现分开评估。
BORE 自己的 README 把意图说得很直白:
为此,BORE 为每个任务引入了一个称为"突发性"的灵活性维度,部分偏离了 CFS 固有的"完全公平"原则。
firelzrd/bore-scheduler,项目 README
突发性是指一个任务自上次通过睡眠、等待 I/O 或主动让出而放弃 CPU 以来累积的 CPU 时间。BORE 把它换算成一个分数,并用它调整每个任务的权重及其唤醒抢占的激进程度,这样不断让出的任务会被视为交互式任务,相对于霸占时间片的任务获得优待。README 自己点明了这种取舍:BORE 会稳定在"对立的贪婪且弱势的任务(通常是 CPU 密集的批处理任务)与谦逊且强势的任务(通常是 I/O 密集的交互式任务)之间的平衡"。给交互式工作加权,和给批处理吞吐工作降权,是同一个操作。
这就告诉你什么手段能检验 BORE 的具体主张:引入竞争 CPU 负载,只改变调度器,然后测量帧时间百分位或输入延迟。当游戏在 CPU 有空闲的情况下运行时,调度器需要仲裁的事情少得多。
一项五款游戏的基准测试 于 2026 年 5 月 16 日发布,在同一块 SSD 和同一套硬件(RTX 5060 Ti 和 Ryzen 9)上全新安装 CachyOS 和 Omarchy,使用相同的 Proton-GE 版本和 1440p 设置。平均帧率只差一到两帧。两天后,同一位测试者发布了 带有完整 MangoHUD 帧记录的第二次对比,加入了 5% Low、1% Low 和帧间隔方差。第二次测试用的是不同硬件,Intel i7-13700 和 Radeon RX 9060 XT,所以它是关于帧稳定性的补充证据,而不是第一次测试在同一硬件上的延伸。两次对比都没有隔离 CPU 调度器,也没有加入刻意的竞争 CPU 负载。
项目方也没有夸大。在 r/cachyos 一个关于游戏性能的帖子里,Peter Jung, CachyOS 的创始开发者之一,直接回答了一位用户:"In gaming not all too much. The newer feature can make a difference tough :)"(游戏上提升不算多,不过新特性还是能带来差别)。
这就留下了两个独立的结论。对于开箱即用的 CachyOS 游戏表现,已发布的测试显示平均帧率差距很小,现在也包含了 1% Low 和帧间隔稳定性的测量。而对于刻意 CPU 争抢下的 BORE,我找不到一项只改变调度器并在该负载下测量响应性的受控公开测试。
为什么即使什么都没测出更快,切换后仍然感觉更快
有两种机制会让换发行版后的机器变得更灵敏,而 CachyOS 的任何优化都没有参与其中:全新安装本身,以及旧系统里某个无关问题的偶然修复。两者都足够具体,你能在自己的情况里辨认出来,这正是它们与笼统的"安慰剂"指控的区别。
先说全新安装。在 r/linuxquestions 一个关于这个问题的帖子里,一位自称没有察觉差异的 CachyOS 用户提出,报告巨大提升的人可能是在拿一个用旧了的安装做对比,而不是全新安装。多年累积的自启动项、孤儿服务、漂移的配置和塞满的磁盘本身就是负载,一个干净的分区把这些一次性全部清除。换发行版会同时改变内核、桌面环境、每一个软件包的版本和每一项默认设置,而一份完整的 Manjaro 与 Ubuntu 对比 要涉及十多个独立维度。事后把提升归到其中某一个,只是猜测。
偶然修复是更鲜明的例子。同一个帖子里,一位评论者描述自己日常使用 Fedora 时遇到一个严重拖慢性能的 VRAM 管理问题,切换到 CachyOS 后问题消失了。之后他又换到纯 Arch,报告的性能与 CachyOS 基本相同,最后得出结论:他已经不知道当初到底是什么不一样。提升是真实的;CachyOS 的编译目标与此毫无关系。
这两点都不足以支持一次干净利落的"辟谣",而反驳这种辟谣最有力的证据是一次受控测试。 Phoronix 的 Arrow Lake 发行版对比 把 Ubuntu 24.10、Fedora Workstation 41、Arch Linux、Clear Linux 和 CachyOS 以默认状态放在同一颗 Intel Core Ultra 9 285K 上,CachyOS 以微弱优势超过了所有对手,包括通常在 Intel 芯片上领先的 Clear Linux。Arrow Lake 不支持 AVX-512,所以这份领先不可能来自 x86-64-v4;它反映的是 CachyOS 的内核与构建选择、软件包优化和默认配置的某种组合。
体验可以是真实的,而归因仍然不确定。Phoronix 的 Arrow Lake 对比是一个有用的反例:即使 x86-64-v4 不可用,默认状态的 CachyOS 安装也能胜过原版 Arch。
如何检查这些是否适用于你的机器
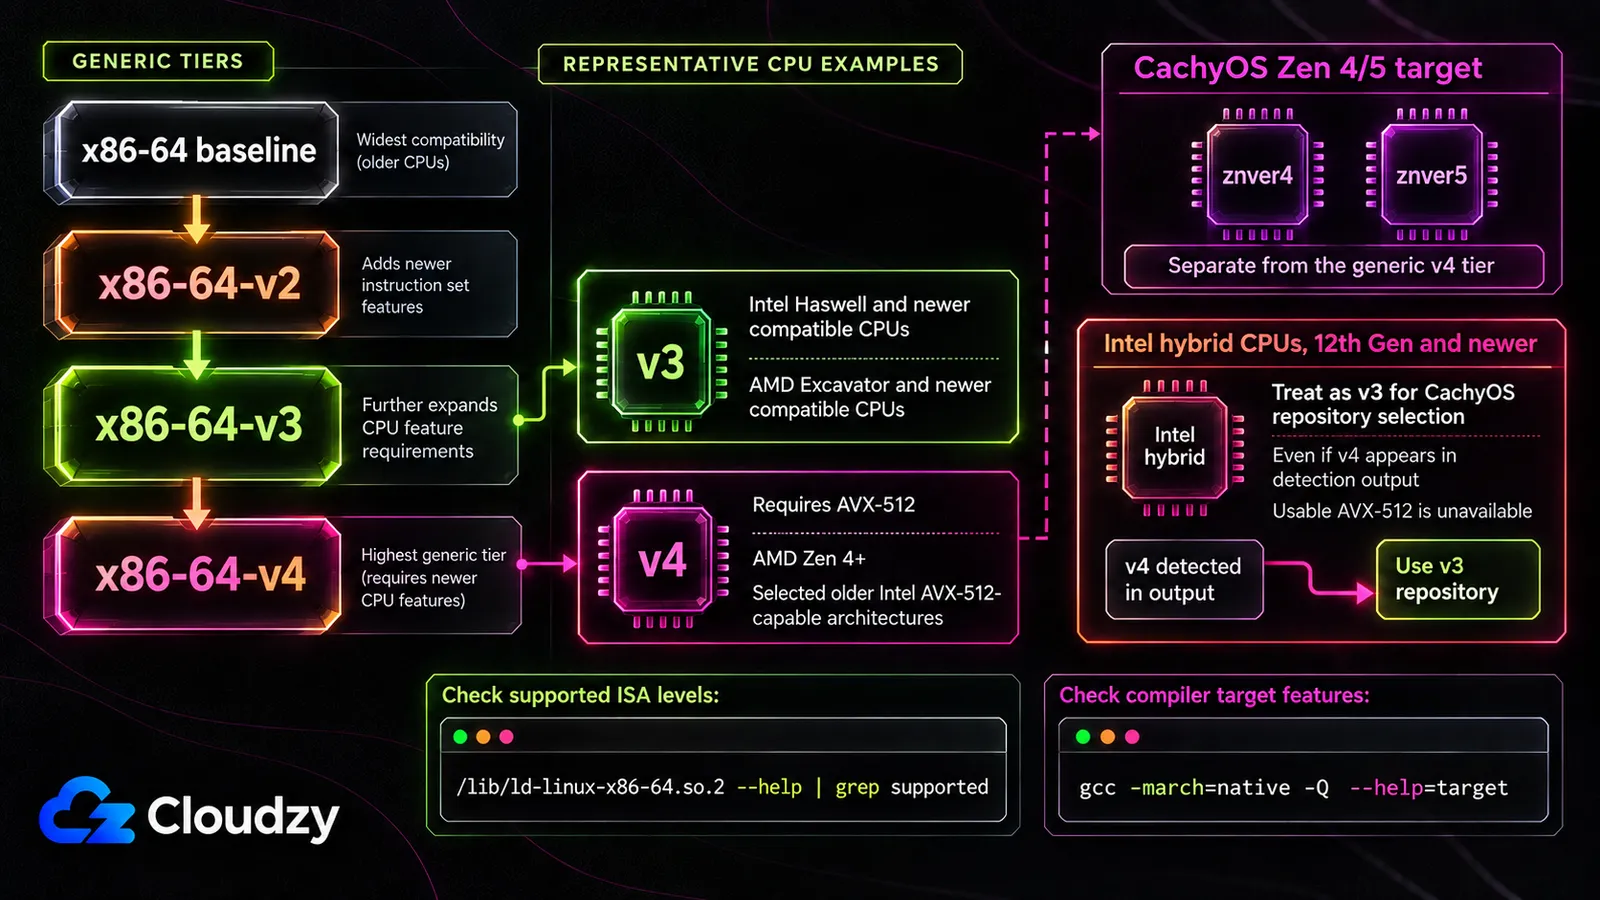
你的 CPU 支持哪个标准化的 x86-64 微架构级别,基本上一条命令就能回答。动态链接器会报告它能使用的 glibc-hwcaps 级别,所以支持的最高 x86-64-vN 条目通常就能告诉你这颗 CPU 够不够格用通用的 v2、v3 或 v4 仓库层级。一个重要例外是 Intel 第 12 代及更新的混合架构 CPU:CachyOS 要求即使输出里出现 v4,也按 v3 处理,因为那里的 AVX-512 不可用。CachyOS 独立的 Zen 4/5 目标也需要单独做架构检查。
/lib/ld-linux-x86-64.so.2 --help | grep supported对于 AMD Zen 4/5,CachyOS 还记录了:
gcc -march=native -Q --help=target 2>&1 | grep -Po "^\s+-march=\s+\K(\w+)$"第一条命令会输出类似这样的内容:
Subdirectories of glibc-hwcaps directories, in priority order:
  x86-64-v4
  x86-64-v3 (supported, searched)
  x86-64-v2 (supported, searched)
这是一颗有 v3 和 v2 但没有 AVX-512 的 CPU。三种结果,三种决定:
- x86-64-v2 之上什么都没有。 v3/v4/Zen 专属重新构建的优势对这颗 CPU 不适用。CachyOS 依然能运行,针对特定软件包的编译器优化以及内核和默认配置的改动仍然可能有影响。
- 支持 x86-64-v3,x86-64-v4 不可用。 就实际的仓库选择而言,这包括 Arrow Lake 这类现代 Intel 混合架构 CPU。在上面引用的对比中,许多变化很小,一些编码和压缩负载收益大得多,而有些软件包出现退步。
- 支持 x86-64-v4。 AVX-512 为可向量化的负载提供了更多理论上的空间,但并不保证全系统范围的大幅提升。
如果你的 CPU 够格,而你想要的只是软件包这一半,那么不必重装系统。CachyOS 的仓库可以添加到现有的 Arch 系统上,ALHP 也发布了官方 Arch 仓库在每个 x86-64-vN 级别上的重新构建, 在 Arch Wiki 上有文档 ,并附带自己的注意事项:必须使用 DKMS 软件包来替代直接链接的内核模块,而给内核编译设置 -march "不会带来任何显著的结果"。两条路线给你的都只是重新编译的软件包,内核补丁集和调度器变体一概不包含。
先运行这条命令。它把一场关于发行版的争论变成一个关于你自己机器的事实,这是这个问题里唯一一个你今晚就能自己解决的版本。

在拥有 root 权限、NVMe 与 AMD EPYC 强大性能的 Linux VPS 上构建应用。
查看 Linux 套餐常见问题
CachyOS 真的能提升游戏性能吗?
就平均帧率而言,几乎没有。2026 年 5 月的一次五款游戏对比只发现一到两帧的差距,两天后的跟进测试也测量了 1% Low 和帧间隔稳定性。两次测试都没有引入刻意的竞争 CPU 负载,所以尚未解决的问题是资源争抢下的调度器响应性,而不是帧间隔稳定性有没有被测过。
我的 CPU 支持 x86-64-v3 或 v4 吗?
在 CachyOS 或 Arch 上运行 /lib/ld-linux-x86-64.so.2 --help | grep supported ,即可查看为你的 CPU 检测到的标准化 glibc-hwcaps 级别。x86-64-v3 要求 AVX/AVX2 时代的特性集,v4 则增加 AVX-512。对于 Intel 第 12 代及更新的混合架构 CPU,CachyOS 建议即使输出里出现 v4,也把系统按 v3 处理;Zen 4/5 用户还应检查单独的 znver4/znver5 目标。
为什么重新编译的软件包带来的差别没有更大?
因为有些高度优化的代码在运行时已经被分派到针对特定 CPU 的实现上。数学和密码学库经常对热点函数使用函数多版本化或 IFUNC,所以重新构建软件包主要帮助的是编译器仍能在全局上进一步优化或向量化的代码。
不换发行版能用上 CachyOS 的优化软件包吗?
能。CachyOS 的仓库可以添加到现有的 Arch Linux 安装上,ALHP 项目也发布了针对 x86-64-v2、v3 和 v4 的官方 Arch 仓库重新构建,在 Arch Wiki 上有文档。两者给你的都只是重新编译的软件包,不包括 CachyOS 的内核补丁集、替代调度器或安装程序的默认设置。
讨论
评论
登录后参与讨论。