

你亲手做的东西已经跑在生产环境里。你的监控要么根本没有,要么只是一个探活 ping,而上周那次故障还是用户先告诉你的。你去找的每一个答案,最后都指向同一个名字。
这篇 Prometheus 评测讲的是两件同时成立的事情之间的落差。它免费且开源,无论规模多大都没有许可证费用,也没有按指标计价的账单。它同时也要花掉你一个晚上,外加一门你还不会的查询语言。它是一个基于拉取模式、自带告警的指标采集器,而且是相当优秀的软件。但它是不是适合你此刻正在运行的这套环境,是另一个问题,也是真正值得回答的那个问题。
简短版本
- 结论:个人和小团队自建场景 3.5 / 5。 如果你的主机与服务集合相对稳定,你愿意花时间学 PromQL,并且希望拥有完全属于自己、既无订阅费也无存储账单的指标,那么 Prometheus 值得跑起来。
- 如果你需要的答案只是“它还活着吗”,那就跳过它。 一个探活工具能让你快得多地拿到这个答案,而为了这件事搬出 Prometheus,等于花一门查询语言的代价去回答一个十分钟就能搞定的问题。
- PromQL 是那笔反复出现的成本。 部署是一次性成本。可一旦你的问题超出了现成仪表盘和 Grafana 的可视化查询构建器,你就又回到 PromQL 里了。
- 维护成本取决于这套环境里有多少是你手工管理的。 形态稳定的机群监控起来很便宜。而那种不断增加、减少、重命名主机的机群,正是成本悄悄累积的地方。
- 这个结论只适用于小规模自建。 到了 Kubernetes 和生产级 SRE 的量级,Prometheus 完全是另一回事,本文并不打算回答那个问题。
这篇评测是怎么做出来的: Prometheus 免费且开源,所以这里不存在任何厂商关系,也没有人给我寄过任何东西。版本信息和存储行为来自 Prometheus 自己的文档。资源占用数字和部署耗时来自两份独立发表的实测,并在各自被引用的位置注明出处。两者不一致的地方,你看到的会是两个数字,而不是取平均。
这篇评测涵盖什么
上面的结论是有边界的,而这里的边界比通常更重要,因为在不同规模下 Prometheus 表现得像是完全不同的工具。
- 这里评估的是单台 VPS 和小项目场景下的 Prometheus 自建:几台主机和服务,一个人照看。
- 不涉及 Kubernetes。Prometheus Operator、ServiceMonitors 和 kube-prometheus-stack 属于另一个运维世界,这里的结论对那个世界只字未提。
- 不是 Alertmanager 路由指南。告警功能存在且能用;但配置路由、静默和接收器是另一个独立话题。
- 不是安装教程。这里的问题是到底该不该跑它。如果这个问题你已经想清楚了,我们的 Grafana 与 Prometheus 的 Docker Compose 指南 里有完整步骤。
- 也不是 exporter 大盘点。只有在 exporter 会改变答案的地方,它才会出现。
Prometheus 做对了什么
Prometheus 不花你一分钱。不是“带付费升级的免费套餐”,也不是“超过指标额度前免费”。 仓库全程采用 Apache 2.0 许可 核心项目没有付费版本,任何地方都没有按主机、按指标或按标签计费。Prometheus 唯一会产生的账单,就是它运行所在的那台服务器。
对于你打算长期依赖的东西,“三年后它还在吗”是个合理的问题,而在这件事上,胜算大概已经是开源世界能给出的最好水平了。Prometheus 于 2018 年 8 月从 CNCF 毕业,是史上第二个做到这一点的项目,仅次于 Kubernetes。版本发布也很稳定, v3.13.2 于 2026 年 7 月底发布;由于该发布线属于长期支持线,它可以获得 缺陷、安全和文档方面的修复 长达一年,所以保持补丁更新并不意味着要追着每一个小版本跑。
数据模型正是它周边生态如此深厚的原因。Prometheus 通过 HTTP 抓取指标,并用指标名加上键/值标签来标识每一条时间序列,这让写一个 exporter 变成一件小事。因此几乎你可能跑的任何东西都有对应的 exporter:节点指标、Postgres、Nginx、Redis,还有用于那些只能从外部探测的对象的 blackbox 探针。
而且它采集到的东西归你所有,这一点往往不是第一天、而是后来才显出分量。一套小环境的历史数据占用的磁盘微不足道(数字在下面),没人能在下个季度给你重新定价,也没有哪一行账单会因为有人给应用多加了一处埋点而变大。如果你见过托管监控的账单只因为某个开发加了一个标签就往上蹿,整个论点就装在那一句话里了。
Prometheus 在哪些地方比看上去更贵
一篇 dev.to 上在同一台小 VPS 上试用七款监控工具的测试 测得单独部署 Prometheus 需要 15 分钟。像那位测试者一样把它和 Grafana 搭配使用,因为内置的表达式浏览器只是一个执行查询的地方。同一份测试给 Grafana + Prometheus 的数字是 35 分钟才画出第一张图,中间还夹着 YAML 抓取配置。
分钟数是便宜的那部分。贵的是 PromQL。Prometheus 把一切都存成由名称和标签标识的时间序列,而 PromQL 依然是你所提问题底下的那门语言。Grafana 现在有了可视化构建器,你不必手写每一条查询。测试者本人的评价很直白:PromQL 对住在里面的人来说很棒,而他并不住在里面。如果你从没用过查询语言,请给它留出不止一个晚上,并且做好准备:每当可视化构建器不够用时,你都得回到这里。从别人那里抄来的仪表盘回答的是别人的问题。你的问题,是一条你还没写出来的查询。
第三笔成本要过一阵子才会浮现。一份 运维者的三周记录 准确描述了往七节点环境里加一台服务器意味着什么:重新打标签、重新检查抓取配置、修改仪表盘变量,还要改写模板查询,好让新主机出现在下拉列表里。那位运维者三周后放弃了这套技术栈,结论是他花在调仪表盘上的时间比真正盯着基础设施的时间还多。
注意在这类环境里,那笔成本究竟挂在什么上:挂在手工管理的抓取目标和仪表盘上。让 Prometheus 平稳跑上两年,几乎不会额外花你什么。
Prometheus 到底需要多少内存和磁盘?
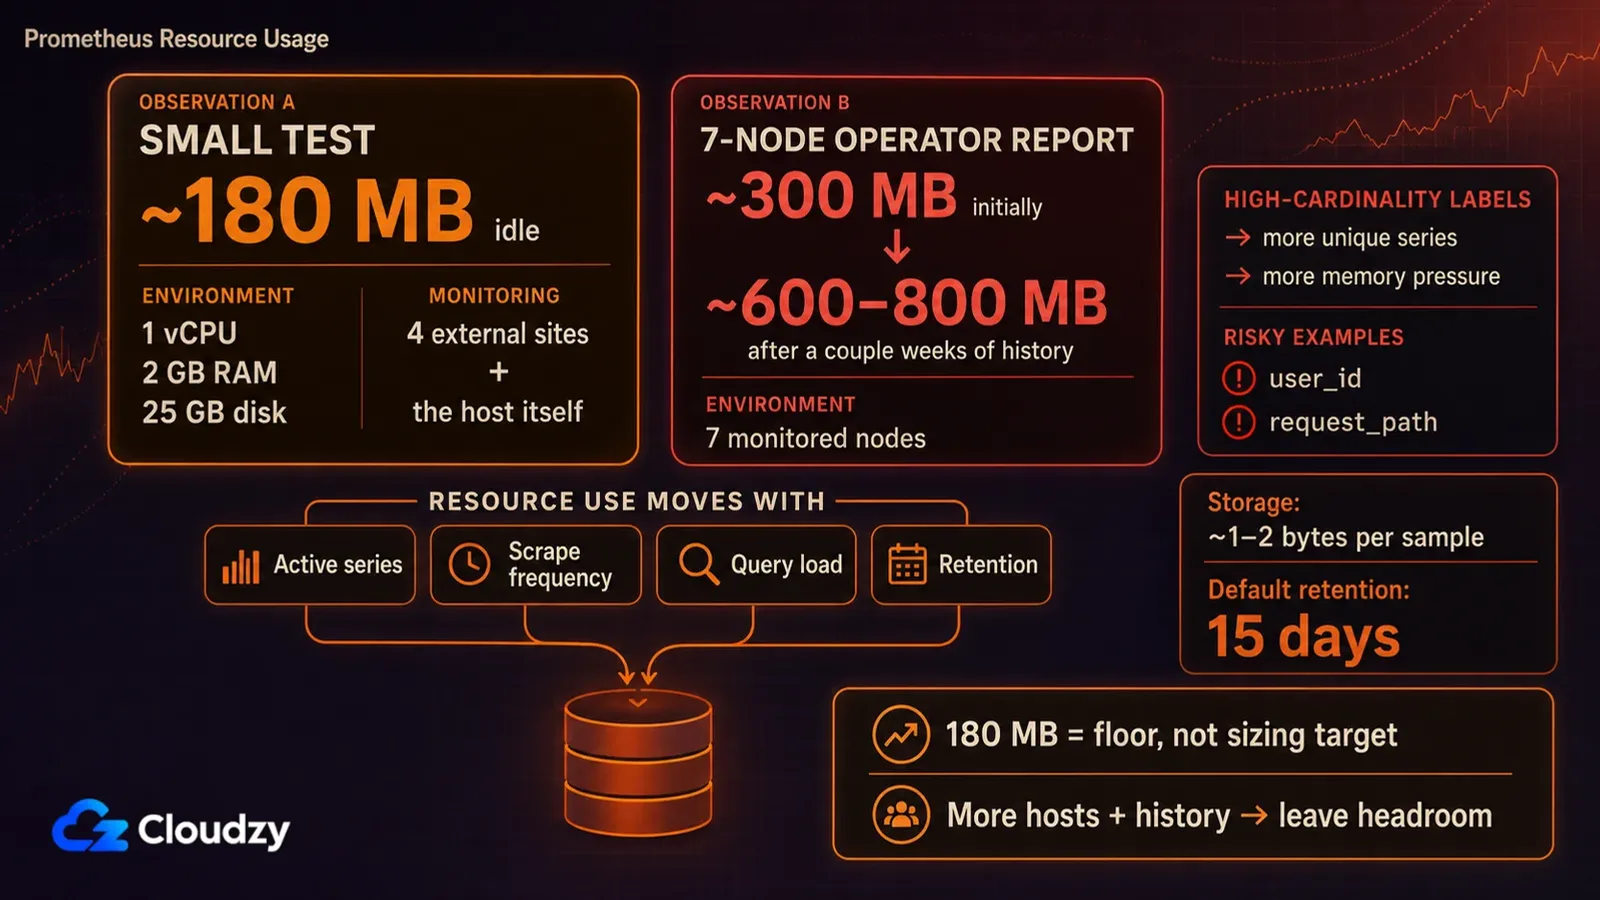
没有固定的要求。活跃序列数、抓取频率、查询负载和保留时长,都比你让它监控多少台服务器更重要。两份已发表的小规模实测把它放在大约 180 MB 到 800 MB 之间,其中较高的那个数字对应七个节点加两周左右的历史数据。
两份测试并不一致,而有用的恰恰是这处分歧。同一份七款工具的 VPS 对比在完全相同的硬件上(1 vCPU、2 GB 内存、25 GB 磁盘、Ubuntu 24.04)运行每一款工具,监控四个外部站点加主机自身,测得 Prometheus 空闲时约 180 MB。同一位运维者则报告说,中心主机上单是 Prometheus 空闲时就在 300 MB 上下,等到攒下两周左右的历史数据后,会向 600 至 800 MB 爬升。
这两者并不是同一种测量,所以把它们平均掉等于把信息扔了。一个是几乎没什么可存的机器上的近空闲读数。另一个是背后带着一整个机群、磁盘上压着历史数据的真实部署。我的判断是:把 180 MB 这个结果当作下限,而不是选型目标。一旦你从多台主机采集并保留历史数据,就该留出余量,而不是照着那个空闲数字来规划。
磁盘是简单的那一半。Prometheus 的存储文档给出的平均值是每个样本 1 到 2 字节,所以为一套小环境保留很长的历史数据并不贵。坑在默认值上: 保留时长默认为 15 天 除非你设置了保留时间或保留大小。它离“一整年”只差一个启动参数,而这正是那种你宁愿现在就知道、也不愿等到第一次去翻上个月的数字、却发现它们三周前就过期了的默认设置。
把内存数字推上去的是基数:不同时间序列的数量,一个指标上标签的每一种唯一组合都会变成一条独立的序列。在高流量指标上选错一个标签,产生的序列数可能比多加五台服务器还多,而且它是悄悄地做这件事,速度就等于你流量本身的速度。(用户 ID 或请求路径看起来是绝佳的标签,直到你数一数它们到底有多少个。)
任何你看到的关于 Prometheus 的内存数字,只有在你同时知道背后有多少条序列时才有参考价值。
当你的 Prometheus 服务器宕机时会发生什么?
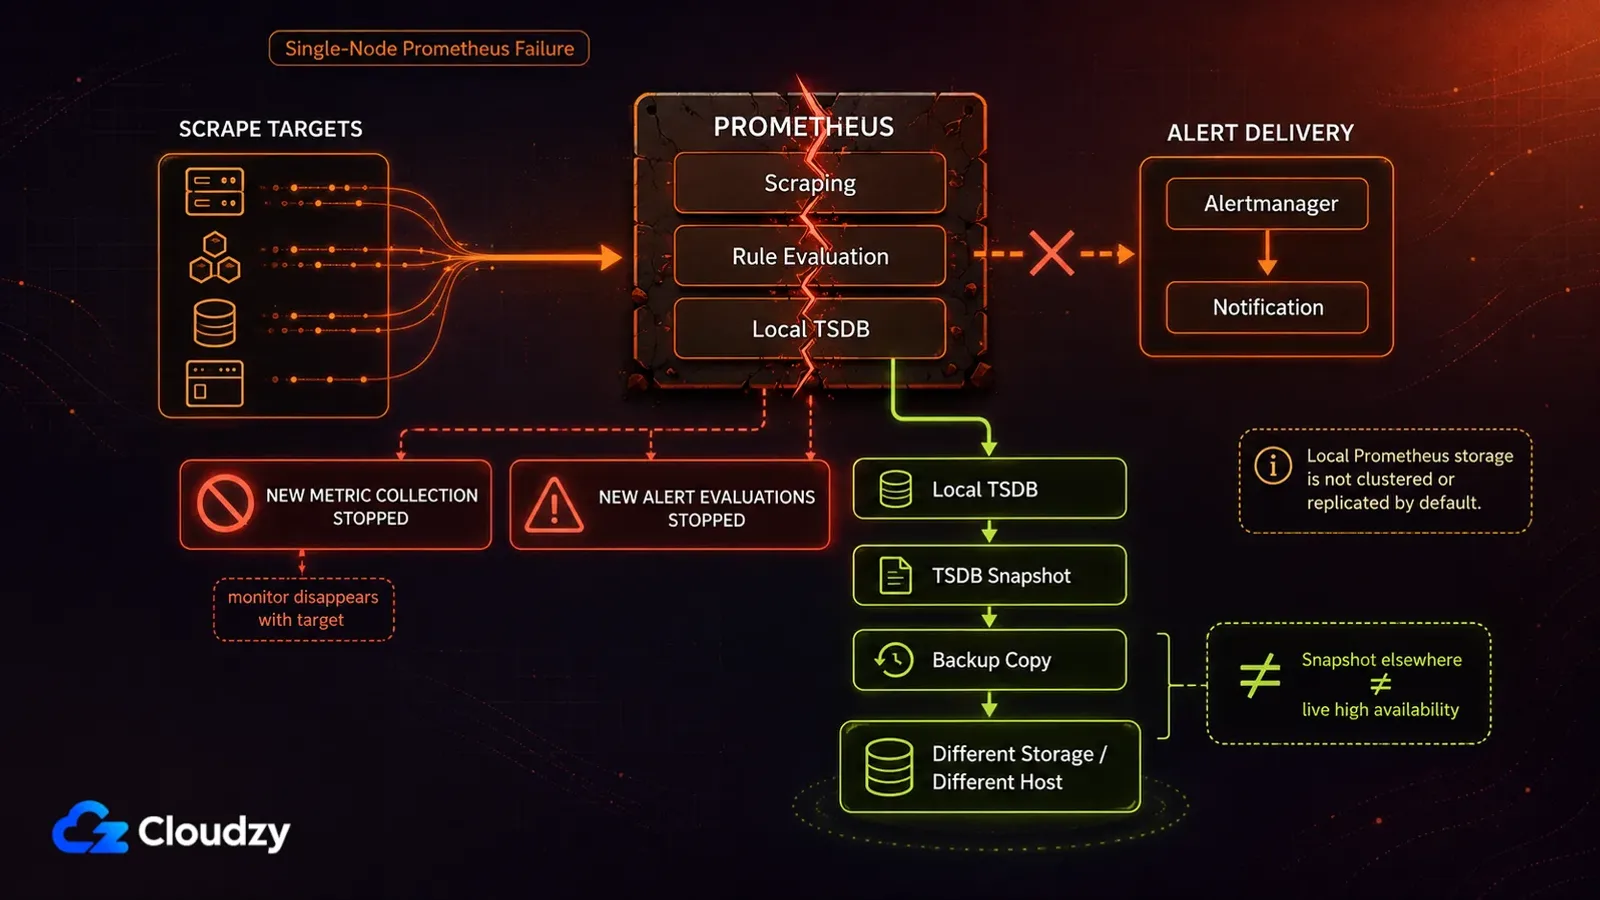
Prometheus 自己的存储文档说得很直接:本地存储 既不做集群也不做复制,因此它扛不住磁盘或节点故障。每台服务器在设计上都是独立的,不依赖网络存储,也不依赖远程服务,这恰恰是它易于运行的原因,也恰恰是它暴露在风险中的原因。
At solo scale that turns into two problems. If the box holding Prometheus dies, new alert evaluations stop, and your history goes with it unless you were taking TSDB snapshots and managing it like the single-node database it is, taking TSDB snapshots and copying them somewhere else. And if that box is also one of the machines being monitored, which on a one-server setup it inevitably is, then the thing that tells you something broke is the same thing that broke. (Yes, that's about as useful as it sounds.)
这个项目还就自身说明了第二条边界,而它敢这么说是值得称道的: 如果你需要 100% 的准确度,比如按请求计费,文档明说 Prometheus 是错误的选择,因为它采集的数据很可能不够详细也不够完整。你要开票的那些数字请用别的工具,把 Prometheus 留给监控。厂商通常不会主动这样说自己。
在更大的规模上,这件事已经有成熟的解法,而它们不在本文范围内,理由和 Kubernetes 那套工具一样:它们意味着与本文所讨论的完全不同层级的运维投入。对于单台 VPS,我的判断是:如果你把 TSDB 快照存在别处,或者一开始就接受会丢掉历史数据,那这个风险敞口是可以接受的;但如果 Prometheus 是你和一次无声故障之间唯一的屏障,那它就是个真问题。
谁应该自建 Prometheus?
最能说明 Prometheus 会赚回成本的信号,和你有多少台服务器毫无关系。关键在于六个月后它们还是不是同一批服务器。一组手工配置且稳定的主机意味着配置写一次,历史数据白得;一组不断变化的主机则意味着你要不断回头去动那份配置。
在一套静态环境里,你的 Prometheus 和 Grafana 配置就是对基础设施的一份显式描述:抓取目标、附加在其上的标签,以及建立在这些标签之上的仪表盘。这也正是历史数据就是全部回报的原因。一组稳定主机上一年的数据会告诉你正常是什么样子,而这是在异常演变成故障之前认出它的最可靠办法。
所以第一类人,是手上有一小组变化缓慢的服务器、并且想要的不只是“活着还是挂了”的人:随时间变化的请求延迟、内存趋势,以及一块慢慢变满、慢到你能提前几周看见的磁盘。如果你今天能描述清楚自己的基础设施,并且认为一年后这份描述大体仍然成立,那么你花在部署上的那个晚上就是最后一笔大账。
第二类是任何有意识地学习这套技术栈的人。如果你预计几年后仍然会在管基础设施,无论是自己的还是别人的,那么和 PromQL 相处的那个晚上正是你要的,监控反倒是副产品。这一类在某种程度上把第一类反过来了:稳定性这条测试在这里没那么重要,因为花在重新打标签上的时间,同时也是弄明白重新打标签是怎么回事的时间。对这类读者我会把评分往上调。
第三类关乎所有权,也是人们在没吃过亏之前最容易低估的一类。Prometheus 不按主机、不按指标、也不按标签收费,没有任何一个定价页面能在下个季度从你脚下变掉。相对于 Datadog 这类托管服务,这笔交换是这样的:你放弃打磨过的体验、支持合同和别人替你值的班,换来的是完全属于自己的指标,以及一份不会因为开发多加了一处埋点就往上走的账单。这笔交换划不划算,取决于你自己的时间值多少钱,而这个数字只有你能填(而且它很少是零,哪怕感觉上像是)。
在你下决心之前还有一件事要知道:撑爆 Prometheus 的本地存储并不是死路。VictoriaMetrics 可以接收来自 Prometheus 的 remote write,而且它的 MetricsQL 向后兼容 PromQL,所以你现在写的大多数查询和 Grafana 仪表盘应该都能挺过这次迁移。这是一次迁移,不是重写。
这件事值得每年重新评估一次,而不是一次定终身:今天监控起来很便宜的那套环境,会在你开始重建它的那个季度变贵。

在拥有 root 权限、NVMe 与 AMD EPYC 强大性能的 Linux VPS 上构建应用。
查看 Linux 套餐谁应该跳过 Prometheus?
如果你用来描述自身需求的那句话是“网站挂了告诉我一声”,那你描述的其实是一个探活工具,而 Prometheus 为了这个答案动用的机械实在太多了。 Uptime Kuma 正好就做这一件事,有网页界面,也不会要求你去学一门监控查询语言。这两个工具之间的能力差距极大,但和你要雇它做的这份工作完全无关。
第二类读者,是想要能直接看的图表、又不打算先学一门查询语言的人。Netdata 正是围绕这一点造出来的:按主机划分、立刻就能看的指标,配置少得多,你和图表之间没有任何阻隔。如果你反复在问的问题是“这台机器现在为什么这么慢”,那它是一条短得多的路。
第三类,是基础设施形态经常变、而且还在手工管理抓取目标和仪表盘变量的人。开一周就销毁的主机、被改名的目标、中途换名字的项目。这正是你一次又一次支付配置成本,却从付了钱的那样东西上获益最少的情形,而那样东西就是一个始终认得出来的系统的连续历史数据。
这些都不是在贬低这个工具。这里说的“跳过”,是指在这件事上、在这个规模上跳过。到了 Kubernetes 的规模,服务发现接管了大部分本来要手工接线的活儿,上面几项成本会缩小甚至完全消失,而我对那个规模的判断是:在那里 Prometheus 非常难被击败。但那是另一篇评测了。

常见问题
Prometheus 免费吗?
免费,而且底下没有藏着免费套餐的套路。Prometheus 采用 Apache 2.0 许可,背后没有商业版本,所以既没有会被你越过的指标额度,另一头也没有等着你的升级提示。你付的是基础设施和自己的时间,而不是 Prometheus 的许可费。
Prometheus 需要 Grafana 吗?
不需要,但请把它算进计划里。Prometheus 自带的表达式浏览器存在的意义是跑一条查询、看一眼结果,用来查一次某一件事足够了。而任何你想一直开在第二块显示器上的东西,都是 Grafana 的活儿,这两者几乎总是一起部署。
对单台服务器来说 Prometheus 是不是杀鸡用牛刀?
多数情况下是的。如果你需要知道的只是服务器和它的服务是否还活着,一个探活工具用不到部署时间的零头就能回答。只有当你想要可查询的历史指标,并且愿意为此学会 PromQL 时,Prometheus 才配得上它占的位置。
Prometheus 默认保留指标多久?
15 天,而且它不会事先提醒你。除非你在启动时用保留时间或保留大小参数把窗口调大,否则 Prometheus 会丢弃早于保留窗口的样本。安装当天就把它设好,因为事后再放宽窗口,也换不回早已过期的数据。



讨论
评论
登录后参与讨论。