

PRTG 按传感器计费,一个传感器是一台设备上的一项被监控指标,而不是设备本身。Paessler 自己的价格档位把实际比例定在大约十比一:500 个传感器覆盖约 50 台设备,10,000 个覆盖约 1,000 台。加一组交换机堆叠,开始按端口监控吞吐量,传感器数量就会比设备数量涨得更快。SolarWinds 的计数方式不同,结果却殊途同归。
对于以 Windows 为主的网络,我会把两种 PRTG 与 SolarWinds 的自托管替代方案列入候选:Zabbix,或者在团队已经在运维的前提下选基于 Prometheus 的技术栈。两者之间怎么选,取决于各自在 Windows 主机上能看到什么,以及为了看到这些需要什么。
开始之前先说一点。如果团队里没人有空余时间,PRTG 和 SolarWinds 仍然是正确答案。它们的易用性是你有意购买的产品,物有所值。这里描述的切换是用工时代替许可费,这是一种交换,不是升级。
TL;DR(太长不看版)
- 默认选择是 Zabbix。 Zabbix 把 SNMP 轮询、Windows 代理、模板和告警放在同一个监控平台里。你仍然要运维 Zabbix 服务器、数据库和 Web 前端,但不必为了起步就去拼装各自独立的监控组件。
- 例外是已经在运行 Grafana 和 Prometheus 的团队 用于应用和主机指标。扩展你已经在维护的东西,比再搭一套监控系统便宜。
- Prometheus 本身不会轮询网络设备。
snmp_exporter填补了这个缺口;其默认配置覆盖了许多常见的交换机和路由器,而厂商专有对象或自定义轮询可能需要生成器和额外的 MIB 工作。 - 无代理采集只能看到主机或设备选择公开的内容。 在 Zabbix 中,Windows 事件日志、服务状态和细粒度性能计数器都是代理监控项键。
- 按指标而不是按设备来测算服务器规格。 Zabbix 把一个指标算作一个监控项加一个触发器加一个图形,并把大约 1,000 个指标对应到 2 个 CPU 核心和 8 GiB 内存,大约 10,000 个对应到 4 核和 16 GiB。
PRTG 和 SolarWinds 按什么收费
Paessler publishes its PRTG tiers publicly, priced by sensor count and billed annually, starting from a few hundred dollars a month as of September 2026. Check the current figures yourself before budgeting. There is no perpetual-licence option in the current lineup. The freeware edition stops at 100 sensors, which Paessler describes as roughly 10 devices.
SolarWinds 计的是另一种单位,这条规则很容易被忽略,直到续费报价单送到手上。 SolarWinds 的 NPM 许可模型 写明 NPM“按以下几类被监控网络元素中数量最多的一类授权:节点、接口、卷”。不是总和,而是三者中最大的那个。一个有 80 个节点和 900 个被监控交换机端口的网络,按 900 授权,而不是 80;档位从 SL100 一直到 SLX。无论哪个档位,单个轮询引擎的上限都是 12,000 个元素(节点、接口和卷的总和,而非其中最大者),超过就要再加一个有授权的轮询引擎。
两种模型的实际效果是一样的。决定监控什么的是许可档位,而不是网络。你想监控的接口之所以一直没被监控,是因为监控它们会越过某条界线,而这笔代价从来不会出现在发票上。
值得运行的两条自托管路线
Zabbix 是一个围绕中央服务器、数据库和 Web 前端构建的单一监控平台。服务器轮询 SNMP 设备,接收 Windows 代理的数据,并在同一产品内应用模板、触发器和告警。与拼装一套基于 Prometheus 的网络监控栈相比,需要你自己集成的独立组件更少。你安装它,指向主机,挂上模板即可;模板是覆盖一类设备的、可复用的监控项、触发器和图形集合。
从许可说起。 Zabbix 的许可页面 写明从 7.0 起的每个版本都以 GNU Affero 通用公共许可证第 3 版发布,而 6.4 及之前的版本都是 GPLv2。无论规模多大,软件本身都没有许可费。Zabbix 把技术支持作为单独的可选订阅出售,并请商业用户购买某个级别的支持,但产品中没有任何功能被锁在这笔购买之后。
第二条路线是 Grafana、Prometheus 和 VictoriaMetrics。它只在一种情况下是正确选择:你已经在用这套栈处理应用和主机指标,并且已经有人在维护它。如果你正是这种情况, 在单台 VPS 上的完整搭建 已经是一个解决了的问题,你只是在扩展熟悉的东西。没有人需要学习新的数据模型。

这条路线的缺口在网络设备。Prometheus 抓取 HTTP 端点,不直接讲 SNMP。网络设备通常通过 snmp_exporter来处理,它轮询设备并把结果暴露出来供 Prometheus 抓取。它的 默认配置 包含了诸如 if_mib之类的模块,因此在许多交换机和路由器上做标准接口监控并不需要生成自定义配置。只有当你需要厂商专有对象、自定义遍历或默认未包含的 MIB 时,生成器才会成为额外工作。所以 Prometheus 路线要维护的部件比 Zabbix 多,但生成器并非每台设备都必需。
LibreNMS 是这个领域的第三个名字,围绕自动发现构建:它通过 SNMP、CDP、LLDP、OSPF、BGP 和 ARP 遍历网络,找出里面有什么。当发现是首要需求时,它是合理的选择。但它不会改变 Windows 采集这个问题,而这个决定正是在这里定下来的。
各条路线如何看待 Windows 主机
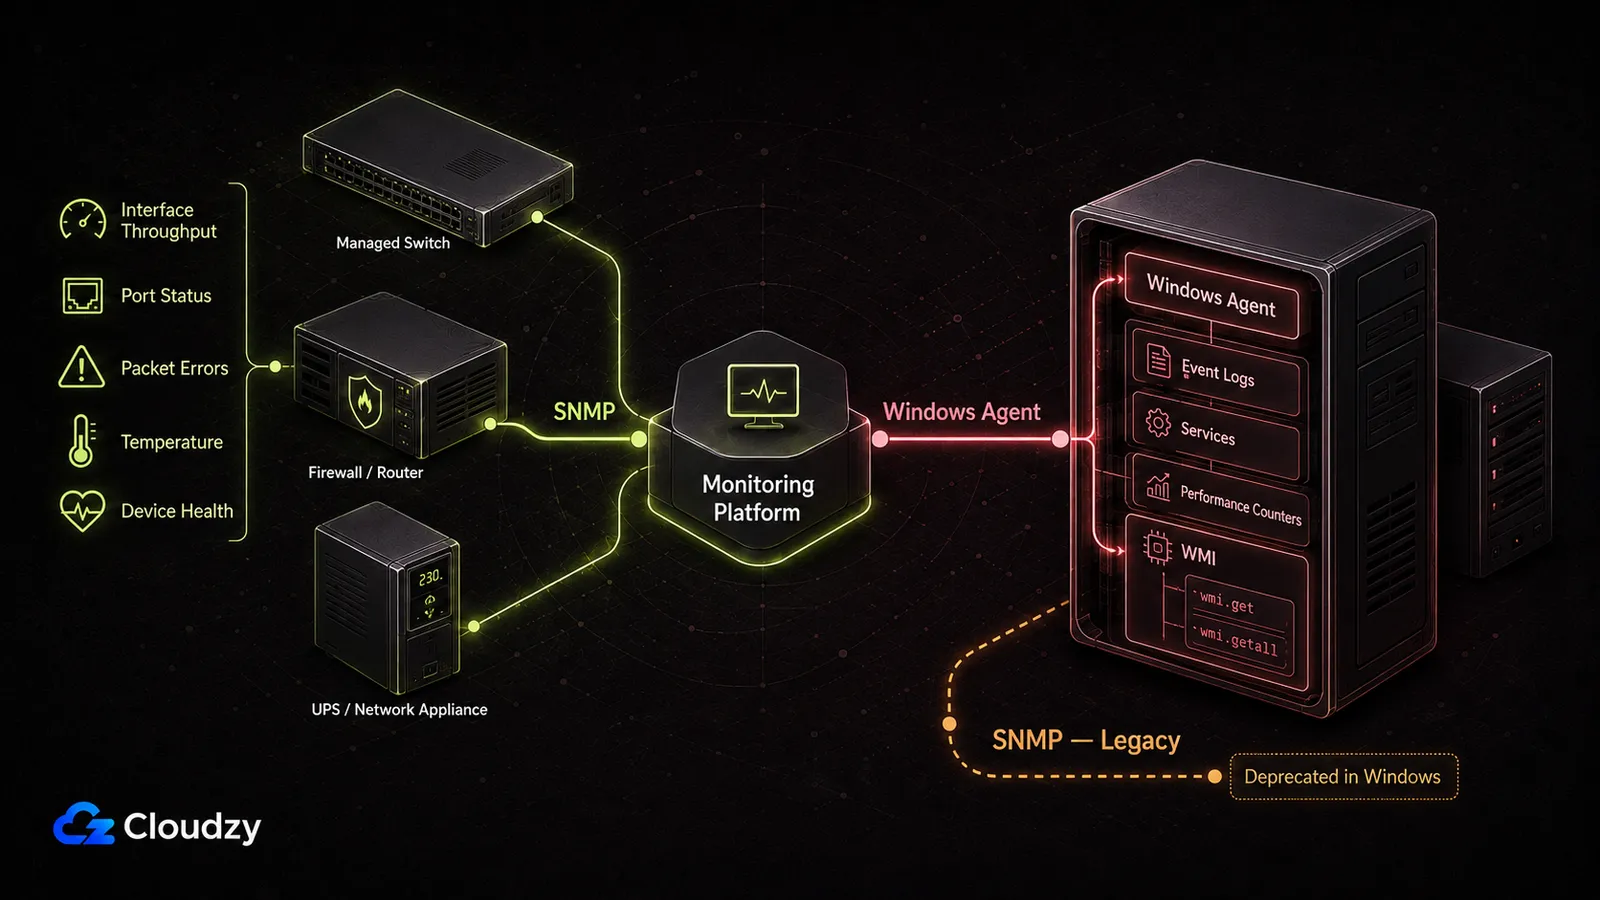
Windows 监控可以走 SNMP、远程 WMI 或已安装的代理。具体走哪条路,取决于监控产品和所采集的指标。具体到 Zabbix,内置的 WMI 检查是通过 Windows 代理运行的。
SNMP
一次 SNMP 轮询向设备索取某个编号对象的当前值,该对象由 OID 定位,OID 是设备 MIB 中的一个位置。返回的只有设备公开的内容,别无其他。对受管交换机、防火墙或 UPS 来说,这通常就够了:接口计数器、端口状态、错误率、温度、机箱健康状况。
在 Windows 上,情况就单薄得多。Microsoft 的 SNMP 与 WMI SNMP Provider 弃用通告 确认这两项功能都已弃用,所以我会把 Windows SNMP 当作遗留兼容路径,而不是新部署的默认选项。Zabbix 仍然提供 Windows by SNMP 模板,但原生代理能让你看到操作系统内部多得多的信息。
WMI
WMI 可以在不给目标安装监控代理的情况下远程查询,这正是 PRTG 之类的产品能把它用作无代理 Windows 采集方式的原因。Zabbix 的做法不同。 它内置的 WMI 检查, wmi.get 和 wmi.getall,是 Windows 代理的监控项键,所以这些查询由被监控机器上的 Zabbix 代理或代理 2 执行。
当监控产品直接使用远程 WMI 时,它还会带来自己的网络要求。在当前的 Windows 系统上, RPC 从 TCP 135 端口起步 ,通常再通过动态高位 TCP 端口范围(一般为 49152 到 65535)协商连接。目标上的防火墙和 WMI 权限必须放行该连接。
对这次比较而言,这个区别比协议本身更重要:PRTG 无需安装监控代理就能使用远程 WMI,而 Zabbix 是通过代理获得针对 Windows 的 WMI 可见性。
原生代理
Windows 专属的深度就在代理里。Zabbix 的文档列出了 Windows 专属键: eventlog 用于监控 Windows 事件日志, perf_counter 用于任意 Windows 性能计数器, service.discovery 和 service.info 用于服务状态。它们全部都是代理监控项键。
代价在于部署。在你在意的每台 Windows Server 和每台工作站上装一个代理,意味着要推送一个软件包、维护一个版本、维持一条防火墙规则。这是一项长期的运维承诺,也是许可费节省的对价。
无代理采集受限于主机或设备选择公开的内容,而在 Zabbix 中,事件日志和细粒度性能计数器都在代理监控项键之后。
并排对比
比较围绕四件事:工具到底会不会通过 SNMP 轮询网络设备,有没有 Windows 代理,能看到 Windows 主机多深,以及在你和一个可用系统之间还隔着多少拼装工作。许可放在旁边,因为它正是这次评估的起因。
| 工具 | SNMP 设备轮询 | Windows 监控 | 安装工作量 | 许可 |
|---|---|---|---|---|
| Zabbix | 内置 | 代理:事件日志、服务状态、性能计数器和 WMI;通过 SNMP 只有粗略状态 | 中等:一台服务器,然后是模板 | AGPLv3,无许可费;支持单独出售 |
Grafana + Prometheus + VictoriaMetrics (+ snmp_exporter) | 非内置;需要 snmp_exporter 作为独立组件 | 没有原生 Windows 代理;主机指标来自独立的导出器;事件日志不是原生支持 | 高:多个组件;自定义 SNMP 可能需要生成器方面的工作 | 开源组件,无许可费 |
| 在线状态与可用性监控器 | 没有 | 仅限服务可达性和响应时间 | 低:几分钟 | 视工具而定 |
如果需求是“某个服务停止响应时一分钟内通知我”,那么可用性监控器就是尺寸合适的工具,另外两个对此都过于庞大。但它不会去轮询交换机获取接口吞吐量,也不会读取 Windows 性能计数器,所以它不能替代 PRTG 或 SolarWinds。那是另一项工作,只是有时会被误认为是同一项。

该运行哪一个
运行 Zabbix。对于没有现成 Prometheus 投入的、以 Windows 为主的网络,它是短得多的那条路。你仍然要运维一台服务器、一个数据库和一个 Web 前端,但监控模型、模板和告警都在同一个产品里,而不是从多个监控组件拼装出来。
对于要长期运行的监控部署,请使用当前的 Zabbix LTS 分支,而不是短期的标准版本。Zabbix 的 LTS 生命周期 为每个版本提供三年完整支持,再加两年有限支持;在这里,这一点比追逐最新功能版本更重要。
例外很窄也很具体。如果你的团队已经在生产环境中运行 Grafana 和 Prometheus 处理应用和主机指标,并且那套栈已经有人负责,那么 snmp_exporter 就是给已有维护的系统做加法,而不是再多一套要维护的系统。这个条件是合取的:两半都必须成立。去年某个人搭起来之后就没人管的 Grafana 实例不算。
如果没人有时间,那就续费。这不是含糊其辞,而是另一种情况,有另一个正确答案。切换会把许可账单变成运维账单:代理推送、模板工作、升级,还要有一个足够懂系统、能在凌晨两点修好它的人。已经满负荷的团队会把这件事做得很糟,或者根本不做;而无人维护的监控比昂贵的监控更糟,因为它会悄无声息地失效。
混合方案是真实可行的:把现有产品保留在不断缩小的关键系统核心上,把其他一切迁到 Zabbix,让许可档位随时间下降。这行得通。但这也意味着同时运行两套监控系统并核对它们的告警,所以要把它当作有截止日期的过渡状态。
迁移中留不下来的东西
Zabbix 自己的迁移指南 有一节标题叫“不会迁移的内容”,这份清单比“迁移”这个词暗示的要长。历史数据和传感器读数不会过来。自定义的 PRTG 通知和依赖关系不会。地图和仪表盘不会,因为两个产品对它们的建模差异大到重建胜过转换。传感器本身也不会,因为 Zabbix 用的是完全不同的概念。
设备名、IP 地址和接口类型可以带过去。就连这些,也要通过针对两边 API 的自定义导出导入脚本来完成。指南明确说,没有官方工具可以在两个平台之间直接迁移。
有一个团队记录了这在实践中的代价:大约 500 台虚拟机和物理服务器,在 PRTG 上用了约七年,用六个月的低优先级项目时间从零重建。他们的 2,500 个 PRTG 传感器变成了 43,000 个 Zabbix 监控项,这直白地说明了两套系统的计数方式差别有多大。
“从头开始。从 PRTG 迁到 Zabbix 没有‘按下这个按钮就迁移’的选项,就算有,这样的事情也是一个不重复以往设计错误的好机会。”
这只是一家组织的经历,不是基准。规模更小的环境不会产生那样的数字。能带走的是规划前提:预算的是重建时间,而不是迁移时间。
按你离不开的东西来安排重建顺序。如果你担心的是告警的连续性,先重建通知规则,让仪表盘晚一点。如果担心的是报表历史,在旧许可失效前把需要的导出来。它不会跟你一起走。
服务器规格测算
Zabbix 的硬件要求 把大约 1,000 个被监控指标的小型安装对应到 2 个 CPU 核心和 8 GiB 内存,把大约 10,000 个指标的中型安装对应到 4 核和 16 GiB。申请资源时就按这些数字来。
规格测算出错的地方在于单位。Zabbix 把一个被监控指标定义为一个监控项加一个触发器加一个图形。指标不是设备,也不是主机。一台 Windows Server 贡献的指标数量取决于你配置了多少监控项:CPU、内存、每个文件系统、每个服务、每个你采样的计数器。设备数量并不能很好地指导你需要多大的机器。一个听起来很小的环境,可能没人做任何特别的事就落到了中型档位。
有两样东西比主机数量更快地推高这个数字。第一是轮询频率:把刷新间隔减半,该间隔上每个监控项的写入速率就翻倍。第二是历史保留,因为数据库会随着你保留原始值的时长而增长。设备数量的影响主要体现在每台设备贡献的被监控项数量上。
如果你的环境在普通刷新间隔和适度保留的前提下接近 1,000 指标的示例,小型档位是合理的起点。如果你每三十秒采样一次性能计数器,还要保留一年的原始历史,那就不是了。Zabbix 明确表示,它公布的数字是“供起步参考的规模和硬件配置示例”,并建议在投入生产硬件之前先在预发布环境做基准测试。这是厂商自己的提醒,请照字面理解。
Zabbix 的服务器组件只支持 Linux 和 UNIX;在 Windows 上只支持代理。
指标不是设备,而两者之间的倍数才决定机器的大小。

在拥有 root 权限、NVMe 与 AMD EPYC 强大性能的 Linux VPS 上构建应用。
查看 Linux 套餐监控服务器放在哪里
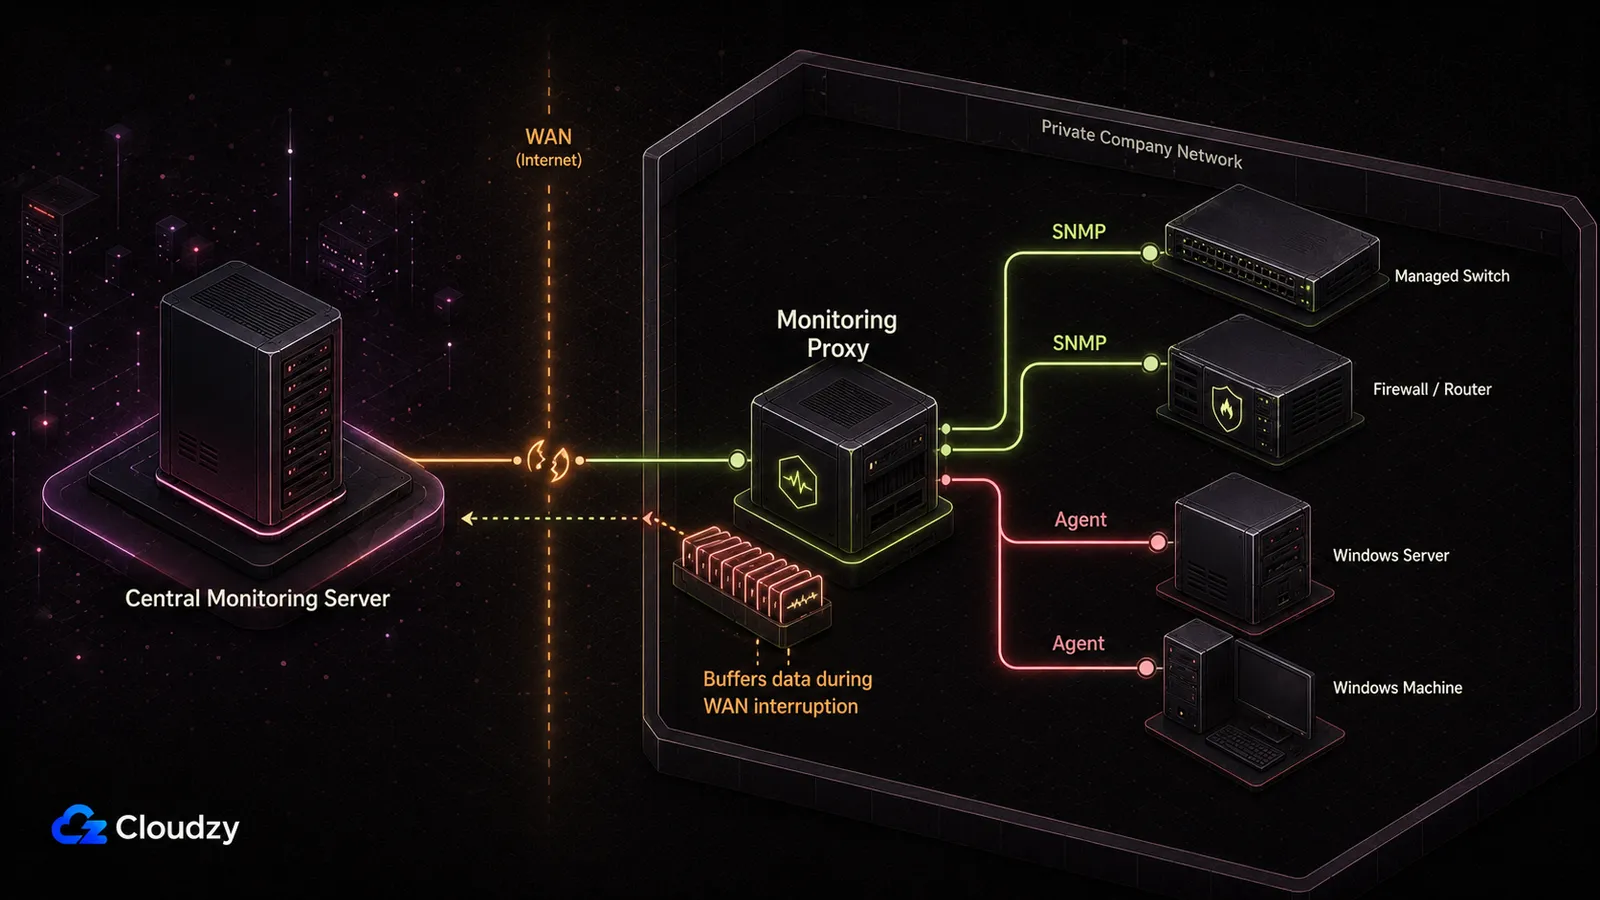
如果你需要监控在整个站点故障时仍然存活,就把中央 Zabbix 服务器放在该站点的故障域之外。这样站点上行链路中断时,被监控的网络可能下线,但不会把监控服务器一起拖下水。
对于私有网络,一个 Zabbix 代理服务器 可以放在站点内部,从周围的系统采集。该代理服务器可以在本地处理 SNMP 和代理检查,把采集到的数据回传给中央服务器,并在两者之间的连接不可用时缓冲监控数据。这样中央服务器可以留在站点之外,而不需要每台私有交换机、防火墙和 Windows 主机都能从互联网直接访问。
VPS 是运行这台中央服务器的一个实用去处。如果你想跳过初始安装,直接开始配置主机和模板,Cloudzy 提供基于 Ubuntu Server 24.04 LTS 的一键部署 Zabbix 服务器 。
常见问题
Zabbix 真的免费吗?
是的。Zabbix 从 7.0 版起以 GNU Affero 通用公共许可证第 3 版发布,无论你监控多少设备或指标,软件本身都没有许可费。Zabbix 把技术支持作为单独的可选订阅出售,但产品的任何功能都没有被锁在它后面。运行 Zabbix 的成本是它所在的服务器,以及你花在运维上的时间。
我需要在每台 Windows Server 上都安装代理吗?
不需要在每台 Windows 机器上都装,但如果你想要 Zabbix 原生的 Windows 监控深度,就要计划在你最在意的服务器上安装代理。SNMP 能提供粗略的无代理数据,不过 Microsoft 的 Windows SNMP 功能已经弃用。Zabbix 内置的 WMI 检查同样通过其 Windows 代理运行,所以在 Zabbix 里 WMI 并不是直接的无代理采集路径。事件日志、服务发现、WMI 查询和细粒度性能计数器用代理;无代理的 SNMP 主要留给网络硬件和遗留的 Windows 场景。
我可以在 Windows 上运行监控服务器吗?
用 Zabbix 的话,不行。 Zabbix 的需求文档 把服务器组件列为仅支持 Linux 和其他 UNIX 平台,并写明“UNIX 是唯一能够持续提供所需性能、容错和韧性的操作系统”。对 Windows 的支持覆盖的是 Zabbix 代理和代理 2,也就是你安装在被监控机器上的东西。监控服务器坐在 Linux 主机上;Windows 环境是它所监控的对象。
Prometheus 能做 SNMP 监控吗?
它自己不能。Prometheus 抓取 HTTP 端点,并使用 snmp_exporter 从 SNMP 设备采集。其默认配置覆盖了许多常见的交换机和路由器,而厂商专有对象或自定义轮询可能需要额外的 MIB 配置和生成器。



讨论
评论
登录后参与讨论。